|
|
|


Infinity III » eng
Питање: Како можете бити сигурни да стварно постоји неизвесност, ако нема враћања у прошлост да би се проверио и неки други избор?
Одговор: Разумео сам то питање, надам се, једноставно је али није лагано. Када се нешто, било шта, догодило како доказивати да му је постојала и алтернатива, да је то заиста могло бити и другачије. Али, са разумевањем се питања и отварају идеје за одговоре. Једне од њих се држим одавно и стога би могла бити вреднија. Ево је.
Ово је физикални резон. Што се тиче форме, приступ проблему је мало другачији (Infinity II). Уместо филозофског, који се помало осећа у прилогу уз горњу слику (бесконачност као концептуална пречица), овде идемо даље у Канторове (1875) бесконачности. Ова теорија информације њих као непротивречне, трајне и на такав начин опсервабилнима сматра „стварнима“. Апстрактно разумемо те неограничености на Гаусов начин, помоћу „одсуства комплетности“, а то је врста перцепција, опажљивости, док у њихово трајање и тачност, опет у математици, одавно не сумњамо.
Отуда је мали корак до прихватања за „стварност“ и бесконачно трајање низа (Packages) тренутака постојања. То је пребројива бесконачност (ℵ0) мања од, рецимо, континуума (𝔠) који је такође „стварност“, па се отвара питање куда са таквом. Затим имамо непребројиву бесконачност опција, јер у пребројивој бесконачности речених тренутака садашњости постоји бесконачан подниз са по бар две опције (основна теза ове теорије). Када је такав концепт непротивречан, а на свој начин нама је перцептибилан, остаје као математички формализам трајан и „стваран“. Ту спадају и оне додатне димензије времена, које опрезно називам псеудо-реалношћу.
Говорим о усклађеном концепту ове терорије, о њеном ширем схваћању „реалности“ које обухвата и математичке истине, или уопште оне које су непротивречне, укључујући све оне које се могу потврђивати физичким експериментима, плус оне које су непопуларне али није доказиво да су неистините. Те три у једном пакету. На тај начин постоје „стварности“ у опцијама чије смо реализације пропустили „бирајући“ текућу. Међутим, таква „неизвесност“ је псеудо-неизвесност и она није крај ове приче.
Ми можемо сведочити о појави живота на планети Земљи, јер смо се на њој могли појавити. Укратко, то би могао бити одговор на питање зашто је текућа реалност таква каква је (перциптибилна, одржива и истинита). У бескрају могућности које нису трајне, какве су и неистине, догодила се реалност и ето ту смо. А она по дефиницији нема могућност да нестане, па је својеврсна бескрај у бескрају. Са друге стране, наша лажљивост као израз многобројне остале несталности шаље нам поруку да физикална одрживост није све што постоји. Такве какве су, одрживе структуре, увек су коначно дељиве.
Поред поменуте „добре попуњености“ свиме и свачиме, бесконачност је по једној особини тешко схватљива нама из света коначне дељивости, а то је способност да буде сопствени прави део. Рецимо, зато се могућност било које лопте да буде разложена на коначан број дисјунктних скупова од којих се онда могу саставити две идентичне копије оригиналне лопте, назива парадоксом (Банах-Тарски). То је додатна особина бесконачности која се скрива испод коначне дељивости физике наших перцепција и она је још непосреднији одговор на горње питање. Једина димензија времена које физички опажамо и немогућност класичног физичког доказа других реалности долази из закона одржања, или коначне дељивости, па онда и стварности која нас одређује.
Prediction » eng
Питање: Разликујете ли прогнозирање од предвиђања и нагађања?
Одговор: Наравно, има разлика. Нагађање је лежерна идеја мале или никакве основе. Предвиђање користи неку логику или податке за предикцију, често субјективне. Прогнозирање је процес процене непознатих ситуација, користећи прошле податке и анализе. Тада се користе и статистички модели са или без прошлих података, често дајући само вероватноће и чинећи је формалнијим типом прогнозе. Међутим, будућност није сасвим извесна и ниједна прогноза није 100 одсто тачна.
Регресиона анализа утврђује међусобне односе појава. На пример, када нас интересује зависност између времена проведеног у спремању испита и добијене оцене на испиту, зарада запослених и њиховог образовања, па каматне стопе и понуде новца или уопште зависност између вредности x и y. У низу ситуација (тренутака) прва и друга узимају вредности xk и yk, где је k = 1, 2, ..., n, које можемо посматрати као парове Pk(xk, yk), а затим их приказивати као тачке Pk у систему апсцисе (x-осе) и ординате (y-осе).
Кратко речено, регресиони модели „предвиђају“ вредност променљиве y на основу познатих вредности променљивих x, са нагласком на употребу неке логике или података за предикцију, често субјективних. Налажење y(x) унутар опсега вредности x1 ≤ x ≤ xn, када су вредности апсцисе дате по величини (x1 < x2 < ... < xn), неформално се назива интерполација, а предвиђање ван тог обима података је екстраполација. Екстраполација која иде даље изван података (од x1 до xn) је све неуспешнија.
Статистичка регресија у свом предвиђању нарочито користи законитости великих бројева теорије вероватноће. Такви говоре да понављање опита, случајних догађаја, за просек резултата (средњу вредност узорка) даје све ближе вредности очекиваном просеку, теоријској средњој вредности. То изоловано гледано па упоређивано са претходним питањем о постојању стварне неизвесности, утврђује небитност „стварне неизвесности“. Када се узму у обзир бесконачни узроци појава чије само површинске, атоме форми можемо физички опажати (интераговати са њима), а на то дода законитост великих бројева, онда постаје неважно јесу ли исходи заиста случајни, или је „случајност“ привидна и последица наше немогућности дубљих увида.
Least squares » eng
Питање: Можете ли ми објаснити обичну методу најмањих квадрата на примеру линеарне регресије?
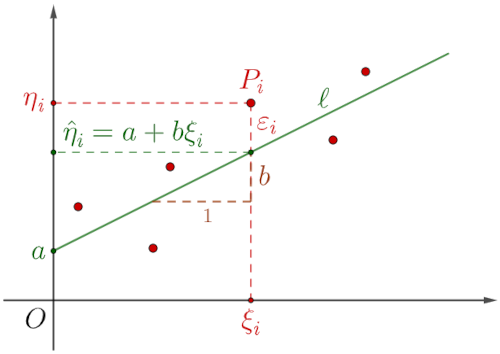
Одговор: На слици десно црвене тачке P1(ξ1, η1), P2(ξ2, η2), ... нека су приказ случајних низова:
x = (ξ1, ξ2, ..., ξn), y = (η1, η2, ..., ηn),
а Pi = (ξi, ηi) је једна од њих. Овде је зелена дуж ℓ: $\hat{\eta} = a + b\xi$ линија регресије. Тако је дефинисана да грешке $\varepsilon_i = \eta_i - \hat{\eta}_i$ квадриране и сабране (RSS — резидуални збир квадрата) чине најмању вредност, број a место где линија регресије сече ординату, а b је нагиб линије, тангенс њеног угла према апсциси. Грешке нека су нормалне расподеле 𝒩(0, σ²), очекивања μ = 0 и варијансе σ².
1. Теорема. Дат је једноставан модел линеарне регресије са независним очитавањима:
$$ y = a + bx + \varepsilon, \quad \varepsilon_i \sim \mathcal{N}(0,\sigma^2), \quad i = 1, 2, ..., n. $$Параметри који минимизирају резидуалну суму квадрата дати су са:
$$ a = \bar{y} - b\bar{x}, \quad b = \sigma_{xy}/\sigma^2_x, $$где су $\bar{x}$ и $\bar{y}$ узорковне (енг. sample) средње вредности, а $\sigma^2_x$ је узорковна варијанса података x, док је σxy узорковна коваријанса између x и y.
Доказ: Резидуални збир квадрата је дефиншемо са:
$$ RSS(a, b) = \sum_{i=1}^n \varepsilon^2_i = \sum_{i=1}^n (\eta_i - a - b\xi_i)^2. $$Изводи по a и b овог збира су:
$$ \frac{d}{da}RSS(a,b) = -2\sum_{i=1}^n (\eta_i-a-b\xi_i) = 0, $$ $$ \frac{d}{db}RSS(a,b) = -2\sum_{i=1}^n (\xi_i\eta_i-a\xi_i-b\xi^2_i) = 0. $$Изједначили смо их са нулама, јер тражимо екстреме. Отуда:
$$ b\sum_{i=1}^n \xi_i + an = \sum_{i=1}^n\eta_i, $$ $$ b\sum_{i=1}^n \xi^2_i + a\sum_{i=1}^n \xi_i = \sum_{i=1}^n \xi_i\eta_i. $$Прва једначина даје нам пресечну тачку:
$$ a = \frac{1}{n}\sum_{i=1}^n \eta_i - \frac{b}{n}\sum_{i=1}^n \xi_i = \bar{y} - b\bar{x}. $$Из друге једначине налазимо нагиб:
$$ b\sum_{i=1}^n \xi^2_i + a\sum_{i=1}^n \xi_i = \sum_{i=1}^n \xi_i\eta_i $$ $$ b\sum_{i=1}^n \xi^2_i + (\bar{y} - b\bar{x})\sum_{i=1}^n\xi_i = \sum_{i=1}^n\xi_i\eta_i $$ $$ b\left(\sum_{i=1}\xi^2_i - \bar{x}\sum_{i=1}^n \xi_i\right) = \sum_{i=1}^n \xi_i\eta_i - \bar{y}\sum_{i=1}^n \xi_i $$ $$ b = \frac{\sum_{i=1}^n \xi_i\eta_i - \bar{y}\sum_{i=1}^n \xi_i}{\sum_{i=1}^n \xi^2_i - \bar{x}\sum_{i=1}^n \xi_i}. $$Бројник препишимо у облик:
$$ \sum_{i=1}^n \xi_i\eta_i - \bar{y}\sum_{i=1}^n \xi_i = \sum_{i=1}^n \xi_i\eta_i - n\bar{x}\bar{y} = $$ $$ = \sum_{i=1}^n \xi_i\eta_i - n\bar{x}\bar{y} -n\bar{x}\bar{y} + n\bar{x}\bar{y} $$ $$ = \sum_{i=1}^n \xi_i\eta_i - \bar{y}\sum_{i=1}^n \xi_i - \bar{x}\sum_{i=1}^n \eta_i + \sum_{i=1}^n \bar{x}\bar{y} $$ $$ = \sum_{i=1}^n (\xi_i\eta_i - \xi_i\bar{y} - \bar{x}\eta_i + \bar{x}\bar{y}) $$ $$ = \sum_{i=1}^n (\xi_i - \bar{x})(\eta_i - \bar{y}). $$Називник се може преписати у облик:
$$ \sum_{i=1}^n \xi^2_i - \bar{x}\sum_{i=1}^n \xi_i = \sum_{i=1}^n \xi^2_i - n\bar{x}^2 = $$ $$ = \sum_{i=1}^n \xi^2_i - 2n\bar{x}\bar{x} + n\bar{x}^2 $$ $$ = \sum_{i=1}^n \xi^2_i - 2\bar{x}\sum_{i=1}^n \xi_i + \sum_{i=1}^n \bar{x}^2 $$ $$ = \sum_{i=1}^n (\xi^2_i - 2\bar{x}\xi_i + \bar{x}^2) $$ $$ = \sum_{i=1}^n (\xi_i - \bar{x})^2. $$Враћајући ове преписане облике у горњи разломак, добијамо:
$$ b = \frac{\sum_{i=1}^n (\xi_i - \bar{x})(\eta_i - \bar{y})}{\sum_{i=1}^n (\xi_i - \bar{x})^2} $$и када бројник и називник поделимо са n излази:
$$ b = \frac{\sigma_{xy}}{\sigma^2_x}. $$Са већ нађеним $a = \bar{y} - b\bar{x}$, oвим b је теорема доказана. ∎
2. Резултат ове теореме може се писати у облику:
$$ y = a + bx, \quad a = \mu_y - b\mu_x, \quad b = r\frac{\sigma_y}{\sigma_x}, $$где су μx и μy математичка очекивања низова x и y, док су σx и σy корени варијанси. Број r = r(x, y) је Пирсонов коефицијент корелације који сам у „фебруарским“ (писани су раније) блоговима означавао са κ(x, y) посебно због тумачења квантне спрегнутости (Singlet) и Белове теореме. Следећи пример је наставак примера из тог блога.
3. Пример. Нађимо обичну линију регресије за низове варијабли:
x = (22, 35, 29, 34, 39, 42, 45), y = (12, 24, 17, 23, 29, 33, 36).
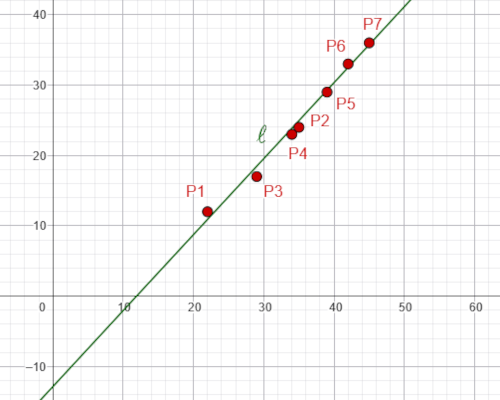
Решење: Задати су низови тачака Pi(xi, yi), где i = 1, 2, ..., 7:
P1(22, 12), P2(35, 24), P3(29, 17), P4(34, 23), P5(39, 29), P6(42, 33), P7(45, 36).
У претходном блогу (Boiled frog) већ је израчунато:
μx = 35, μy = 25, σx = 7,28, σy = 7,92, r = 0,994.
Отуда налазимо:
a = μy - bμx, b = rσy/σx, a = -12,85, b = 1,08.
Линија регресије, y = a + bx, приказана је на горњој слици лево. ∎
4. Транслација случајне променљиве, X' = X + c, када је c = const, не мења варијансу, σ²[X'] = σ²[X], која мери распон око средње вредности, јер тим се не мења распоред. Међутим, мења им се очекивање E[X'] = E[X] + c. То даље значи да транслација случајних променљивих X или Y константом c у обичној регресији најмањих квадрата (OLS) транслира линију регресије и мења место пресека са осом, али њен нагиб остаје непромењен. Другим речима, додавање константе \(c\) независној променљивој X и/или зависној променљивој Y помера регресијску линију вертикално или хоризонтално без утицаја на њену стрмину. Ово ће бити корисно запажање касније.
Globalism II » eng
Питање: Кажете да су и локална дивергенција и глобална конвергенција неминовности, а опет да није могуће њихово тачно предвиђање?
Одговор: Да углавном. Међутим, иако то изгледа апсурдно, као да једно противречи другом, изглед вара. Њихова сагласност не да се оспорити, прво имплицира друго и, посебно је важно, запазите да су такав локализам и глобализам две последице начела објективне неизвесности текуће моје теорије информације. Питање је увелико закашњело (Globalism), али ипак ће се добро уклопити у тренутну тему статистичке регресије и не као прилог уз слику (бићу апстрактнији, без конкретне политике).
1. Случајне n-торке бројева x = (ξi) и y = (ηi) можемо изучавати и помоћу процеса који би један пресликавали у други, B: x → y. На пример, ако су сви ξi ≠ 0 за i = 1, 2, ..., n:
$$ \begin{pmatrix} \eta_1 \\ \eta_2 \\ ... \\ \eta_n \end{pmatrix} = \begin{pmatrix} \eta_1/\xi_1 & 0 & ... & 0 \\ 0 & \eta_2/\xi_2 & ... & 0 \\ ... & ... & ... & ... \\ 0 & 0 & ... & \eta_n/\xi_n \end{pmatrix} \begin{pmatrix} \xi_1 \\ \xi_2 \\ ... \\ \xi_n \end{pmatrix} $$Ова матрична једначина, Bx = y, са дијагоналном матрицом B типа n×n има детерминанту:
$$ \det B = \frac{\eta_1}{\xi_1}\cdot\frac{\eta_2}{\xi_2}\cdots\frac{\eta_n}{\xi_n} $$која је производ својствених вредности λ1 = η1/ξ1, λ2 = η2/ξ2, ..., λn = ηn/ξn. Знамо да својствене вредности остају исте у „сличној“ матрици C = P-1BP, где су P и P-1 инверзне матрице, при чему се у сличним матрицама често мењају припадни својствени вектори. Случајни низови x и y из прошлог примера (Least squares, 3) имали би ову детерминанту приближно 0,069.
Кроз две дате тачке, врхове вектора x и y, могуће је повући једну и само једну праву, z = (y - x)t, параметра t ∈ ℝ, али постоји безброј линеарних оператора, попут C, који x пресликавају у y. Штавише, када користимо искључиво сличне операторе, једнаких скупова својствених вредности, опет их има бесконачно много са различитим припадним својственим векторима. Ово је прилог различитости путева глобалне конвергенције (Approaching).
2. Када граф линеарне регресије из претходног примера померимо за |a|, заокружено на 13, тако да је y' = y + 13, нова линија пролази исходиштем. Сваку ординату увећавамо за 13, па имамо:
x = (22, 35, 29, 34, 39, 42, 45), y = (12, 24, 17, 23, 29, 33, 36), y' = (25, 37, 30, 36, 42, 45, 49).
Мењају се дијагонални елементи горње матрице, y = B'x, па и својствене вредности λi. Њихов нови производ тада је det B' ≈ 1,69. Седми корен тих седам фактора биће око 1,08 колико нагиб линије регресије (b = 1,08).
Уопште, ξi не мењају се, али сваки η'i = ηi - a. Тачку пресека a = -12,85 која је негативна одузимали смо. Зато је нова средња вредност:
$$ \bar{y}' = \frac{\eta'_1 + \eta'_2 + ... + \eta'_n}{n} = $$ $$ = \frac{(\eta_1 - a) + (\eta_2 - a) + ... + (\eta_n - a)}{n}, $$ $$ \bar{y}' = \bar{y} - a. $$То пишемо и μy' = μy - a. Како је (читамо из примера):
$$ a = \mu_y - bμ_x = (\mu_{y'} + a) - b\mu_x, $$ $$ \mu_{y'} = b\mu_x, $$па је b = μy'/μx. Када је корелација ових случајних низова велика, као што је ова r = 0,994, количник μy'/μx постаје приближно n-ти корен поменуте детерминанте. Отуда толико поклапање резултата (det B' ≈ bn).
3. На случајан начин појављују се тачке (ξi, ηi) са неограничено растућим i = 1, 2, 3, ..., које смо раније раздвајили у посебне низове x = (ξ1, ξ2, ξ3, ...) и y = (η1, η2, η3, ...) узимајући само по n њихових чланова. Немамо начин да предвидимо око које тачке (ξ0, η0) се оне групишу и то је принцип ове теорије. Оне случајне догађаје који су објективно неизвесни није могуће било каквим нагађањем, прорицањима, изачунавањима нити мерењима предвидети, нити ће то икада бити могуће све до њихове реализације.
То је локална дивергенција. Потом она имплицира да се нити линеарна регресија поменутих бесконачних низова не може сазнавати на основу њихових парцијалних поднизова. Поготово због адаптација у стварним ситуацијама, које кажу да свака нова појава макар неким малим делом утиче на наставке претходних. Сила неизвесности која се преноси кроз појаву нове случајности (тачке, дакле вектора, или стања) стално мења претходну линију регресије и смер глобализације, неспознатљиво. То је начин којим локална дивергенција прави непредвидљивом и глобалну конвергенцију. Њу потиче закон великих бројева теорије вероватноће, али на други начин и линеарна алгебра.
Python program » eng
Питање: Пошаљите ми код у Питону за линеарну регресију?
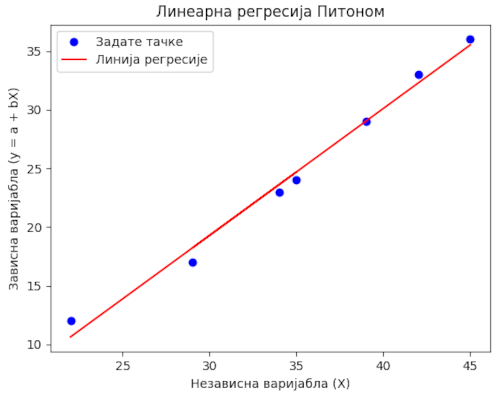
Одговор: На слици лево видите резултат програма из наставка. Подаци су претходни:
x = (22, 35, 29, 34, 39, 42, 45) y = (12, 24, 17, 23, 29, 33, 36)
Коефицијент детерминације (r²) само је квадрат Пирсонова r(x, y) коефицијента корелације; значи пропорцију варијације зависне y променљиве која је предвидљива на бази независне променљиве. Једначина y = a + bx је права која сече ординату на висини a и има нагиб b, иначе тангенс угла до апсцисе. Додатно, на основу нових апсциса X = (10, 20, 30) предвиђене ординате су y = (-2.33898305, 8.47765794, 19.29429892) као бонус. Python (3.11.0):
# pip install numpy pandas matplotlib scikit-learn
from sklearn.linear_model import LinearRegression
import matplotlib.pyplot as plt
import numpy as np
# Sample data, reshape to a 2D array
X = np.array([22, 35, 29, 34, 39, 42, 45]).reshape((-1, 1))
y = np.array([12, 24, 17, 23, 29, 33, 36])
model = LinearRegression()
model.fit(X, y)
r_sq = model.score(X, y)
print(f"Коефицијент детерминације (r^2): {r_sq}")
print(f"Пресек (a): {model.intercept_}")
print(f"Нагиб (b): {model.coef_}")
# Predviđanje na osnovu postojećih podataka
y_pred = model.predict(X)
# Predviđanje na osonovu novih podataka
x_new = np.array([10, 20, 30]).reshape((-1, 1))
y_new_pred = model.predict(x_new)
print("Предвиђање нових, за X = (10, 20, 30):")
print("y =", y_new_pred)
# crtanje
plt.scatter(X, y, color='blue', label='Задате тачке')
plt.plot(X, y_pred, color='red', label='Линија регресије')
plt.xlabel('Независна варијабла (X)')
plt.ylabel('Зависна варијабла (y = a + bX)')
plt.title('Линеарна регресија Питоном')
plt.legend()
plt.show()
На почетку је наведено (pip install ...) како из командног мода рачунара инсталирати Питонов модул, ако га немате. Даље сам скромно наводио коментаре (они почињу са #) да лакше разумете шта програм ради, а да га не оптеретим превише. Поред цртежа, горе лево, програм на екрану даје и следећи текст:
Коефицијент детерминације (r^2): 0.9887085901386748
Пресек (a): -13.155624036979983
Нагиб (b): [1.0816641]
Предвиђање нових, за X = (10, 20, 30):
y = [-2.33898305  8.47765794 19.29429892]
Програм мењајте за своје потребе. Иста верзија као модул је овде.
Spline » eng
Питање: Појасните ми још мало како то градите операторе спојницама?
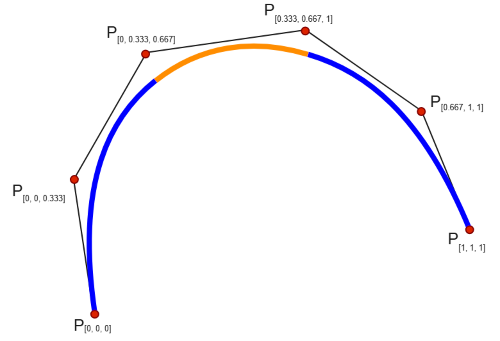
Одговор: Ово је део разговора око стереометрије статистике (Restriction) тамо називаним спојницама, или „сплајнама“ (новост и немам бољи назив), који помало подсећају на ове десно слике, а отуда и забуне.
1. Објаснићу корак по корак, да тај нови појам, овде „спојнице“ $\vec{s}_x$, не помешамо са неким већ познатим и не одлутамо. Пре свега, имамо n-торку бројева x = (ξ1, ..., ξn), чији чланови ξi су случајни (то могу бити и неки други) бројеви средње вредности μx = (ξ1 + ... + ξn)/n. Са таквима формирамо спојнице Sx = (ξ1-μx, ..., ξn-μx), низове који су једнако и вектори. На сликама из навода видимо их као „одбацивања“ пројекција вектора $\vec{x}$ на симетралу квадранта до датог вектора. Они су окомити на те симетрале, а косинуси углова између спојница једнаки су (Пирсоновим) коефицијентима корелације.
2. Скаларни производ две спојнице:
$$ \vec{S}_x\cdot\vec{S}_y = (\xi_1 - \mu_x)(\eta_1 - \mu_y) + ... + (\xi_n - \mu_x)(\eta_n - \mu_y) = n\,\text{cov}(x,y) $$је n пута увећана коваријанса припадних низова x и y = (η1, ..., ηn), други са средњом вредношћу μy = (η1 + ... + ηn)/n. Опет, коваријанса је средња вредност тог скаларног производа. Даље, имамо варијансе:
$$ \sigma^2_x = \frac{1}{n} \sum_{i=1}^n (\xi_i - \mu_x)^2, \quad \sigma^2_y = \frac{1}{n} \sum_{i=1}^n (\eta_i - \mu_y)^2 $$из којих и интензитете вектора спојница, дисперзије:
$$ \sigma_x = \frac{1}{\sqrt{n}}\|\vec{S}_x\|, \quad \sigma_y = \frac{1}{\sqrt{n}}\|\vec{S}_y\|. $$Скаларни производ спојница подељених овим дисперзијама је Пирсонов коефицијент корелације низова x и y:
$$ \frac{\vec{S}_x}{\sigma_x}\cdot \frac{\vec{S}_y}{\sigma_y} = r(x,y), $$у поменутом прилогу означен са κ(x, y). Наставак ове приче нас још више буни, па тај део излагања онда требам тек успорити.
3. Спојнице, или „сплајне“, су низови са нултом средњом вредношћу:
$$ \mu_s = \frac{1}{n}[(\xi_1 - \mu) + ... + (\xi_n - \mu)] = $$ $$ = \frac{1}{n}[(\xi_1 + ... + \xi_n) - (\mu + .. + \mu)] $$ $$ = \frac{1}{n}(\xi_1 + ... + \xi_n) - \frac{1}{n}(n\mu) $$ $$ = \mu - \mu = 0. $$Према томе, спојнице се као и „обични“ низови могу сматрати стањима, када и интерпретације сличних вектора. Њихови унутрашњи (скаларни) производи могу представљати информације перцепције, а уз то можемо говорити и о њиховим линеарним регресијама.
4. Транслацијом (Least squares, 4) линеране регресије, y = a + bx, не мења се њен нагиб b па је паралелним смицањем по вертикали можемо свести на облик (y - a = bx) када она пролази исходиштем. Са друге стране, зна се b = rσy/σx, па примењено на линеарне регресије спојница имамо:
$$ \vec{S}_y = \frac{1}{n}\frac{\vec{S}_x\cdot\vec{S}_y}{\sigma_x\sigma_y}\frac{\sigma_y}{\sigma_x}\vec{S}_x, $$јер спојнице имају нулту средњу вредност (3). Ово можемо писати:
$$ \vec{S}_y = \frac{\vec{S}_x\cdot\vec{S}_y}{\|\vec{S}_x\|\|\vec{S}_y\|}\frac{\|\vec{S}_y\|}{\|\vec{S}_x\|}\vec{S}_x, $$ $$ \frac{\vec{S}_y}{\|\vec{S}_y\|} = \frac{\vec{S}_x\cdot\vec{S}_y}{\|\vec{S}_x\|\|\vec{S}_y\|}\frac{\vec{S}_x}{\|\vec{S}_x\|}, $$ $$ \vec{s}_y = (\vec{s}_x\cdot\vec{s}_y)\, \vec{s}_x, $$где су $\vec{s}_x$ и $\vec{s}_y$ јединични вектори спојница $\vec{S}_x$ и $\vec{S}_y$.
5. Следећи корак је примена овога на линеарне операторе, јер такође и они имају особине вектора. Тако долазимо до поменуте „конструкције“ оператора спојницама, из разговора и постављеног питања, али које је посебна тема линеарне алгебре. Стања су репрезентације вектора каква чине низови независних особина различитих јачина испољавања. Ако интеракције разумемо као комуникације, онда се скаларни производи појављују као информације перцепције. Тако ови вектори постају теме физике и теорије информације.
Даље је ствар у томе да су процеси интерпретације оператора, а „стања процеса“ посебан њихов вид који се може схватати и као обичан вектор, рецимо низ или усмерена дуж попут брзине или силе. Штавише, процес времена, због „сила вероватноће“, понашаће се као „гурање“ физичких (статичких) стања у будућност и одговараће особинама вектора. Форма му је векторска и оно што можемо извући из рачуна вектора преносимо на интерпретацију.
Magnitude » eng
Питање: Шта би се могло рећи са таквом интерпретацијом линеарне регресије (Spline, 4), са нагибом b који није број?
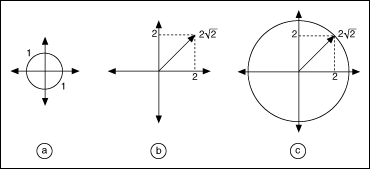
Одговор: Излазимо из оквира класичне статистике и на оне формуле не гледамо на такве начине. То прво. За наставак, радим на линеарној алгебри, затим на припадној области функционалне анализе. Могу нешто од тога изнети укратко.
1. На тој слици, горе лево, је линк са објашњењем преноса норме вектора на норму матрице која их пресликава. У 2-норми вектора (еуклидској) је корен збира квадрата елемената вектора x = (ξ1, ..., ξn) његов интензитет, па је та норма једноставно фактор са којим морамо множити јединичну лопту да би вектор x остао у њој:
$$ \|x\|_2 = \sqrt{|\xi_1|^2 + ... + |\xi_n|^2}, \quad \xi_1, ..., \xi_n \in \mathbb{C}. $$Одговарајућа норма оператора мери максимално „истезање“ које такав примењује на било који вектор простора на који делује. Једнако важи за матрице које су интерпретације оператора у разним базама тог простора. Прецизно, кажемо да је (линеарни) оператор A у векторском простору X ограничен ако постоји ненегативан број M такав да је:
$$ \|Ax\| \le M\|x\|, \quad \forall x \in X. $$Инфимум бројева M (најмањи од њих, или лимес) је норма оператора A. Оператор је, дакле, ограничен ако има коначну норму и тада важи:
$$ \|Ax\| \le \|A\|\|x\|, \quad \forall x \in X. $$Када су без ознаке подразумевамо еуклидске норме.
2. Када користимо само јединичне векторе истог простора, за норму оператора важи:
$$ \|A\| = \sup_{x\in X\setminus\{0\}} = \frac{\|Ax\|}{\|x\|} = \sup_{\|x\|=1}\|Ax\|, $$па норму оператора оганичава норма пресликаних јединичних вектора. Обзиром да су спојнице у поменутој једначини јединични вектори, ову (Spline, 4) напишимо $\vec{s}_y = A\vec{s}_x$ и приметимо да су норме ове регресије јединичне, $\|A\| = 1$. Како је $\vec{s} = \vec{S}/\|\vec{S}\|$, а називник је пропорционалан дисперзији σ (и корену константног броја компоненти), то се спојнице Sx пресликавају у веће Sy тако што им дисперзије σy сразмерно расту. Важи и обрнуто, краће спојнице имаће мање дисперзије.
3. Узимамо ли сирове спојнице (ненормиране) и одговарајуће преписке коефицијента нагиба линије регресије у оператор, b = rσy/σx → B, а због |r| ≤ 1 и претходног ∥A∥ = 1 следи σy ≥ σx. Овај раст говори о тенденцији разводњавања случајних догађа у оваквој мојој интерпретацији наводно линеарне регресије. Ово је мало дужа прича (за ову прилику) и навешћу само да иде са шумом ланца Маркова, канала преносника информација, који настаје вишком информација, дакле, са повећањем неизвесности и дисперзије порука.
4. Третман овог проблема детерминантом је једна сасвим друга прича, такође занимљива али одвојена. Наиме, погледајте ове две једноставне матрице чије су детерминанте један (det C1 = det C2 = 1):
$$ C_1 = \begin{pmatrix} 1 & c \\ 0 & 1 \end{pmatrix}, \quad C_2 = \begin{pmatrix} \sqrt{1 + c^2} & c \\ c & \sqrt{1 + c^2} \end{pmatrix} $$али када c → ∞, тада ∥Cx∥ → ∞ за многе векторе x. Иначе, детерминанта је скалар (реалан или комплексан број) за квадратне матрице, која ће рећи да ли се матрица може инвертовати (детерминанта је тада различита од нуле) и колико она скалира запремине/површине, али нема правила да норма мора бити већа од детерминанте (или обрнуто).
Entropy III » eng
Питање: Управо приметих једну новину, како и сама линеарна регресија открива спонтани раст ентропије?
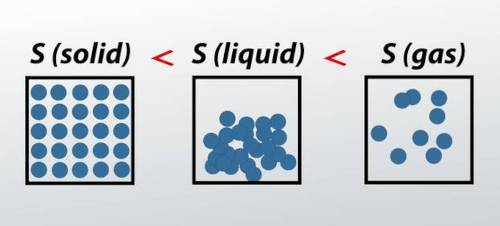
Одговор: Да, то сте добро видели из претходног одговора. Линија регресије, y = a + bx, паралелно померана мења место пресека са ординатом a, али не мења нагиб b = rσy/σx. Померена тако да има a = 0, биће y = bx и тада се боље види деловање коефицијента b, са независне случајне променљиве x на зависну y. Коефицијент r ∈ [-1, 1] показује корелацију променљивих x са y, а σx и σy су њихове дисперзије, корени варијанси.
Приметили сте (Magnitude, 3) да применом реченог на спојнице Sx и Sy, а посебно је то видљиво њиховим нормирањем, имамо σx ≤ σy, јер је |r| ≤ 1. Ово значи да дисперзија зависне варијабле има тенденцију раста. Попут ентропије о чијој званичној верзији имам издвојено мишљење а које сам више више пута помињао, у овим блоговима (Entropy II), мало детаљније (Ентропија), или раније (Информација Перцепције, стр. 70).
1. Када немамо довољно података онда смо неинформисани, али ако смо превише информисани онда смо дезинформисани. За разлику од мртве физичке природе, виталност је додатак са којим имамо веће могућности избора, да не морамо следити принцип најмањег дејства, али такође да можемо лагати. У томе је разлика физике и теорије информације. Прва се не бави лажима и само делимично може разумети ентропију.
Игла је добро сакривена у пласту сена (Unaffected, 2). Слично, сметње у преносу података, које се могу пратити и Марковљевим ланцима (Black Box II), крећу гушењем „праве“ информације са „погрешнима“, односно засићењем послате поруке. Послата порука заправо не нестаје, она бива затрпана и игнорисана, непрепознатљива. Ту „необичну“ појава можемо приметити и унутар класичних физичких у тежњи статусу кво. Најмање дејство није неко које иде у нулто и испод, него на свом путу наилази на равнотежне положаје, оптимуме. Превише опадања физичког дејства и премало једнако су одбојни телима у кретању.
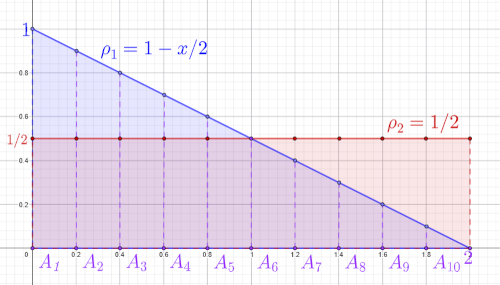
2. На слици лево су графови две густине вероватноћа, за x ∈ [0, 2]:
$$ \rho_1(x) = 1 - \frac12x, \quad \rho_2(x) = \frac12, $$и ρ1(x) = ρ2(x) = 0 за x ∉ [0, 2]. А површина правоуглог троугла са катетама 1 и 2 испод косе (плаве) до апсцисе је 1⋅2/2 = 1. Такође је 1 површина (црвеног) правоугаоника страница 1/2 и 2. Према томе, оне тако описују расподеле вероватноћа.
3. Шенонова информација прве густине је значајно мања од друге:
$$ S_1 = -\int_0^2 (1 - \frac12x)\ln(1 - \frac12x)\,dx = \int_1^0 2y\ln y\,dy = $$ $$ = \int_1^0 \ln y\,dy^2 = y^2\ln y\Bigg|_1^0 - \int_1^0y^2\,d\ln y $$ $$ = -\int_1 ^0y^2\cdot \frac{1}{y}\,dy = -\int_1^0 y\,dy $$ $$ = -\frac{y^2}{2}\Bigg|_1^0 = \frac12 = 0,5. $$Овде је кориштена смена y = 1 - x/2, па је x = 2 - 2y. Међутим, Шенонова информација друге густине је:
$$ S_2 = -\int_0^2 \frac12 \ln\frac12\, dx = (\frac12\ln 2)\,x\Bigg|_0^2 = \ln 2 \approx 0,69. $$4. Десет догађаја A1, ..., A10 пореданих дуж апсцисе, према првој густини имају тим редоследом опадајуће вероватноће. Први A1 је највероватнији и најчешће се дешава (понављањем), али ако се деси то онда и није нека вест. Друга густина ρ2 има униформну расподелу и сваки од десет датих догађаја једнако (не)очекујемо, сваки је једнако маскиран са преосталих девет и зато је њена информација већа, али је безлична, неуређена. Она је један од примера како ентропија са својим нередом смањује (корисну) информацију, који понекад користим да видимо да порастом ентропије губимо информацију конкретних података.
Karma II » eng
Питање: Пркоси ли тако ентропија начелном минимализму?
Одговор: Та линеарна регресија указује на могући спонтани раст дисперзије, а са тиме и „нереда“, односно ентропије у класичном смислу, али приметан (Entropy III, 2) је пад изложености сваке појединачне поруке укључујући значајне. Другим речима, бука гуши информације, па уколико неред посматрамо као спонтани раст информације треба у њему видети и њен спонтани пад.
1. Ефикасност је ослобађање вишка избора (Unaffected, 2), јер у реалном времену није продуктивно превише проверавања поузданости, тачности ставки или реалности појава, па нас у најбољем случају та презасићеност води у грубе процене и неизбежне грешке. Крајњи домети интелигенције затим су ограничени обманама (Mastery). Међутим, путеви обмана зачас постају испадање из воза реалности која не мари за лаж и оставља је иза у јарку поред пута, а на крају стварности и истине су једине неуништиве. Оне опстају и по томе их разликујемо од фикција. На тај начин, такође, повећање дисперзије не значи већу информисаност. Као по некој карми, лоше одлуке знају кажњавати и вишак слобода претварати у мањак на лош начин.
2. Разликујемо унутрашњу и вањску информацију (In and Out), при чему ова прва увећавана постаје пригушена а што видимо код већих таласних дужина (дужих неодређености положаја) у њиховој лошијој интеракцији са околином, кажемо већој продорности. Такође, тело бржег релативног кретања учесталије интерагује са истом нашом околином, презасићено је информацијама и део таквог система налази се у паралелној стварности, у додатним димензијама времена. Слично је са гравитацијом где такође опажамо успоравање временског тока, овде схваћено начином налажења посматраног уједно у нашој и у псеудо-реалности. Оно што ми видимо у тим ситуацијама су губици информације због пораста ентропије.
3. Краткорочно гледајући пораст ентропије, у облику нереда можда личи на пораст количине могућности (информације), али дугорочно ентропија је расипање и хлађење, губитак садржаја и динамике. На крају то постаје и губитак интеракција, односно комуникација. У том смислу се парчићи стакла, чаше која је пала са стола и разбила се, праве безличним и попут строја војника који изнутра и даље садрже своје индивидалне особине и различитости, али их вани не показују. Ентропија током свог спонтаног пораста губи активну информацију и на свој начин сведочи о начелном минимализму.
Dual » eng
Питање: Субјекат и објекат заједнички простор не виде једнако?
Одговор: Да, перцепције су им другачије на разне начине. Ту припадају и разлике дуалних опажања истог простора. Тада имају различите метрике:
$$ d(x,y) = [\sum_{i=1}^n (\xi_i - \eta_i)^a]^{1/a} $$када су тачке n-торке координата x = (ξ1, ..., ξn) и y = (η1, ..., ηn). Али, ако је у једном простору a = p > 1, онда је у дуалном a = q, при чему је:
$$ \frac{1}{p} + \frac{1}{q} = 1. $$Те две метрике једнаке су само ако p = q = 1/2, а то је једино у еуклидској 2-норма метрици.
1. Овакве бројеве (r = 1) видимо на претходној слици, горе лево:
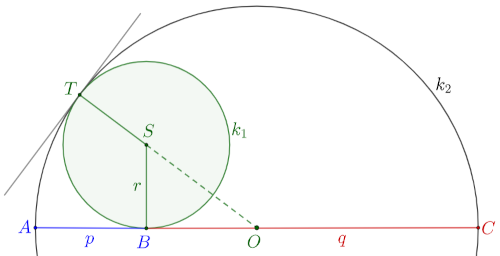
$$ \frac{1}{p} + \frac{1}{q} = \frac{1}{r}. $$Мањи круг k1 центра S и полупречника r уписан је у полукруг k2 центра O и полупречника p + q са додирним тачкама T и B. Тачка B дели пречник на два дела AB = p и BC = q, а тангента у тачки T је окомита на пречнике оба круга, па је T-S-O, то су три колинеарне тачке са центром мањег круга између. За доказ једнакости имамо правоугли троугао SBO:
$$ SB^2 + BO^2 = OS^2, $$ $$ r^2 + \left(\frac{b-a}{2}\right)^2 = \left(\frac{a+b}{2}-r\right)^2, $$а након квадрирања и сређивања налазимо тражену једнакост.
2. На слици се види, када је мањи круг (k1) центром (S) приближава рубу пречника (A) смањује се. Обзиром да му је полупречник увек исти (r = 1) то значи да се пречник (p + q) великог полукруга (k2) повећава. При томе p → r = 1, што значи да q → ∞. Један од (мање познатих) примера таквих дуалних метрика су простор вероватноћа и информација (Dual Likely):
$$ d_1(x,y) = |\xi_1 - \eta_1| + ... |\xi_n - \eta_n|, $$ $$ d_\infty(x,y) = \max\{|\xi_1 - \eta_1|, ..., |\xi_n - \eta_n|\}. $$То је случају у класичној теорији када вероватноће сабирамо непосредно, као ненегативне релане бројеве из интервала од 0 до 1. Тада доминирају вести ређих догађаја (није вест када пас уједе човека колика је када човек уједе пса), па су нам водеће оне највеће, максималне. Наиме:
$$ \|x\|_\infty = \lim_{a \to \infty}\left(|\xi_1|^a + ... + |\xi_m|^a + ... + |\xi_n|^a\right)^{1/a} = $$ $$ \lim_{a \to \infty}|\xi_m|\left(|\frac{\xi_1}{\xi_m}|^a + ... + |\frac{\xi_m}{\xi_m}|^a + ... + |\frac{\xi_m}{\xi_n}|^a\right)^{1/a} = |\xi_m|, $$где је ξm апсолутно највећа координата низа x, па је израз у загради 1, тј.
$$ \|x\|_\infty = \max_{1\le i\le n} \{|\xi_i|\}. $$Међутим, у квантној физици вероватноће су 2-норме (Борново правило), па су такве и информације. О дуализму сведочи и интересантна парница Протагоре и Еуатла (Dual Power).
3. Скаларни (или унутрашњи) производ индукује норму (\(||x||=\sqrt{\langle x,x\rangle }\)) ако и само ако норма задовољава закон паралелограма:
$$ ||x+y||^{2}+||x-y||^{2}=2||x||^{2}+2||y||^{2}. $$За p-норме $|x||_{p}=(\sum_i |x_{i}|^{p})^{1/p}$, норма индукује скаларни производ ако и само ако је p = 2 (еуклидска норма). Ово је зато што је скаларни производ једнака мешавина фактора оба узајамно дуална простора (Restriction):
$$ \langle s_x | s_y\rangle = (\xi_1 - \mu_x)(\eta_1 - \mu_y) + ... + (\xi_n - \mu_x)(\eta_n - \mu_y). $$Знамо код оваквих спојница (Spline) да су μx и μy средње вредности низа x = (ξi) и y = (ηi), па је коваријанса:
$$ \text{cov}(x,y) = \frac{1}{n}\langle s_x|s_y\rangle, $$без обзира на врсту дуализма. Ово је произвољно (моје) проглашење и не вреди га тражити у уџбеницима, али ради и не противречи познатим!
4. Међутим, стандардне девијације су изоловане, па користимо дуале:
$$ \sigma_x = \left[\frac{1}{n}\sum_{i=1}^n(\xi_i - \mu_x)^p\right]^{1/p}, \quad \sigma_y = \left[\frac{1}{n}\sum_{i=1}^n(\eta - \mu_x)^q\right]^{1/q}, $$где је p-1 + q-1 = 1. Затим дефинишемо Пирсонову корелацију:
$$ \kappa(x,y) = \frac{\text{cov}(x,y)}{\sigma_x\sigma_y} = \frac{\sum_{i=1}^n (\xi_i - \mu_x)(\eta_i - \mu_y)}{\left[\sum_{i=1}^n (\xi_i - \mu_x)^p\right]^{1/p} \left[\sum_{i=1}^n (\eta_i - \mu_x)^q\right]^{1/q}}, $$ $$ \kappa(x,y) = \frac{\langle s_x | s_y\rangle}{\|s_x\|_p\, \|s_y\|_q}, $$јер се n из бројника крати са n1/pn1/q = n из називника. То је коефицијент корелације сада дуалних простора. Ставимо ли p = q = 2, добијамо његов раније познат облик, овде као посебан случај.
5. Са већим бројем p > 1 мања је p-норма. То је очигледно за ∥x∥∞ ≤ ∥x∥p, јер лево је највећи апосолутни, рецимо |ξm|, од чланова x = (ξ1, ..., ξn), а десно их у збиру има још, па је извесно:
$$ |\xi_m| \le \left(|\xi_1|^p + ... + |\xi_m|^m + ... + |\xi_n|^p\right)^{1/p}. $$Уопште је:
$$ \|x\|_q = \left(\sum_{i=1}^n |\xi_i|^q\right)^{1/q} = \left(\sum_{i=1}^n |\xi_i|^{q-p}\,|\xi_i|^p\right)^{1/q} \le $$ $$ \le \left(\sum_{i=1}^n |\xi_m|^{q-p}\,|\xi_i|^p\right)^{1/q} = |\xi_m|^{(q-p)/q} \left(\sum_{i=1}^n |\xi_i|^p\right)^{1/q} $$ $$ = |\xi_m|^{(q-p)/q} (\|x\|_p)^{p/q}, $$ $$ \|x\|_q \le \|x\|_p, \quad p \le q. $$Мање вредности p (нпр. ∥x∥1) дају већу тежину малим грешкама, док веће вредности p (нпр. ∥x∥∞) доминирају својим највећим компонентама, што их чини мањим укупно у поређењу са збиром свих елемената. Укратко је то и опис онога што ове норме раде случајним низовима.
Hölder » eng
Питање: Шта је са називником корелације, каква је величина производа дуалних норми?
Одговор: То непосредно следи из Хелдерове неједнакости Квантна Механика (Теорема 1.3.3, стр. 190 и даље). За свака два низа x = (ξi) и y = (ηi) и p-1 + q-1 = 1 важи:
$$ |\langle x | y\rangle| \le \|x\|_p\|y\|_q. $$У случају корелације отуда је:
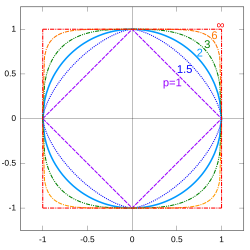
$$ \kappa(x,y) = \frac{\langle s_x|s_y\rangle}{\|s_x\|_p\, \|s_y\|_q} \le 1, $$када 1/p + 1/q = 1, јер горње важи и у случају спојница, па онда и за Пирсонову корелацију. На слици су примери оваквих p-норми за p ∈ {1, 1.5, 2, 3, 6, ∞} где лакше запажамо како те норме деформишу јединичну кружницу ∥x∥p = 1. Постоје и много занимљивија објашњења дуалних простора, евентуално погодна за неке прилике, а овде погледајмо само како се мења права линија променом p-норме.
1. И даље је корелација косинус угла између спојница (сплајни) случајна два низа, $\kappa(x,y) = \cos\angle(\vec{s}_x,\vec{s}_y)$, а линеарна регресија y = a + bx. Када се пређе на поларне координате биће x = r⋅cos(φ) и y = r⋅sin(φ), па имамо:
$$ r\sin\varphi = a + br\cos\varphi, $$ $$ r(\sin\varphi - b\cos\varphi) = a, $$ $$ r(\sin\varphi\cos\beta - \cos\varphi\sin\beta) = a\cos\beta, \quad b = \text{tg}\,\beta, $$ $$ r = \frac{a\cos\beta}{\sin(\varphi-\beta)}. $$Ово је једначина праве у 2-норми (еуклдској), какву је обично познајемо. Угао β је нагиб праве према апсциси.
2. У произвољној p-норми (p ≥ 1), даље имамо:
$$ (x^p + y^p)^{1/p} = \frac{a\cos\beta}{\sin(\varphi-\beta)}, $$ $$ r(\cos^p\varphi + \sin^p\varphi)^{1/p} = \frac{a\cos\beta}{\sin(\varphi-\beta)}, $$ $$ r = \frac{a\cos\beta}{\sin(\varphi-\beta)}\frac{1}{(\cos^p\varphi + \sin^p\varphi)^{1/p}}. $$Ова се једначина своди на еуклидску за p = 2, јер збир квадрата косинуса и синуса је један. Међутим, p-норма је мања када је p већи број, па је тада ово r веће. Горња права тада се удаљава од исходишта.
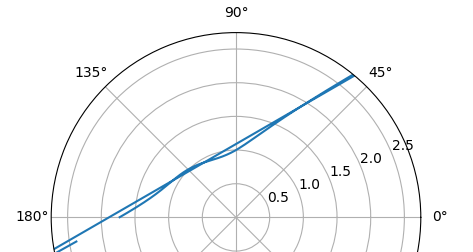
3. На слици лево је права линија y = 1 + tg(π/6)x у 3-норми цртана у Питону. Видимо да она пролази мало изнад 1 ординате и да благо таласа око праве линије. У норми p = 2 то je права линија која сече ординату на висини a = 1 нагибa b = tg(30°), што значи да заклапа угао 30 степени према апсициси (хоризонталној, обично x оси).
4. Ово нису проблеми из просторног распоређивања, нити израчунавања Кристофелових симбола, него су из једног сасвим другог миљеа, рецимо, следећег (Real Life). Узимамо да упоређујемо колико се времена проводи учећи са резултатима тестирања: број часова учења 2, 4, 6; резултат теста 50, 70, 90. Добићемо једначину y = 30 + 10x која би била то што тражимо да није сувише тачна за статистику. Питања линеарне регресије траже и значајне количине неизвесности у овим бројевима какве нема у кретању небеских тела или у теоремама Талеса.
Multilinear » eng
Питање: Можете ли рећи нешто и о вишеструкој линеарној регресији?
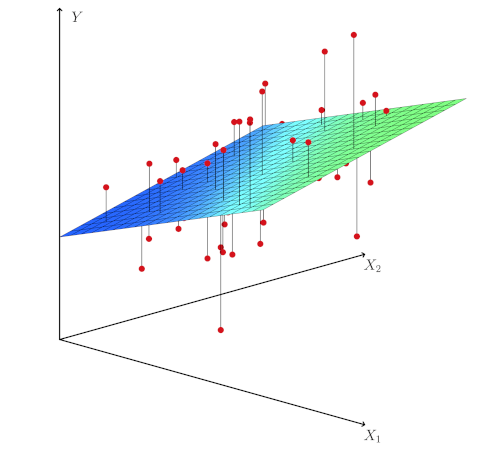
Одговор: Једноставна регресија је однос између једне зависне (y) променљиве и једне независне (x) променљиве:
y = f(x).
Вишеструка регресија (са много променљивих) функција је једне зависно променљиве са многим независним променљивим:
y = f(x1, x2, ..., xn).
Мултиваријантна регресија се односи на више зависних али и више независних променљивих:
y1, y2,..., yn = f(x1, x2, ..., xn).
Претпостављам да је она за коју питате ова средња, називана вишеструка и линеарна, или вишелинеарна:
Y = X1 + X2 + ... + Xn
са случајним променљивим Xi редом за све i = 1, 2, ..., n.
1. То је регресија која подразумева четири предуслова: (1) Односи између зависне и независних променљивих су линеарни; (2) Варијанса грешака једнака је за све независне променљиве, то називамо хомоскедастичност; (3) Резидуали прате нормалну расподелу; (4) Независне променљиве не би требало да буду у високој корелацији, нису близу +1 нити -1.
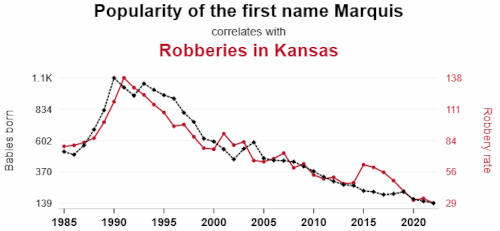
2. Она, вишеструка регресија као и корелација зато ће вишеструко пута патити од „болести“ простих регресија. На пример, од лажних корелација, коинциденција какве очигледно нису и узрочности. Те на слици лево су бројност давања бебама имена Маркиз у САД-у са пљачкама у Канзасу, корелације индекса r = 0,948.
Насумичност варијабли једне n-торке и неке друге n-торке поклапаће се у обиму корелације овог индекса (r ≥ 0,94) са све мањим вероварноћама што је n већи број, али са данас растућим бројем свакаквих статистичких мерења по свету он се може апсолутно и повећавати. Шта ако независне променљиве, попут наведених беба Маркиза и пљачки у Канзасу, покажу корелацију иако ту нема узрочности? Шта тада са налазима вишеструке регресије, а посебно ако немамо сигурности да је нешто само корелација (пука коинциденција) а да није и нешто више (узрочност). Та могућност не смањује, него напротив повећава тешкоће вишеструке регресије.
3. Други пример, сладолед и дављење. Регресија инцидената дављења са продајом сладоледа показаће јаку позитивну корелацију која сугерише да сладолед узрокује дављење! Али, додавање „температуре“ као контролне променљиве у мултилинеарном моделу открива да високе температуре узрокују оба, уклањајући апсурдну узрочно-последичну везу.
Сличан поучан пример десио се на УЦ Берклију, 1970. приликом пријема на универзитет. Подаци су указивали на пристрасност према женама при упису. Међутим, мултилинеарна регресија која је контролисала одређени одсек није показала пристрасност, открила је да су се жене пријављивале на конкурентнија одељења.
4. Незванично, само у овој теорији информације, су реалност, истинитост и одрживост у истој категорији појмова, неуништивих, односно отпорних на проток времена. Упоредимо ли их са Геделовом другом теоремом, која каже да математика не може доказати саму себе (Dogma), намеће се једно необично запажање. Када нисмо у прилици да откријемо контрадикцију, или дефинитиван доказ нетачности, осуђени смо да посматрамо трајање датих стања (исказа, појава, токова) надајући се да јењавају. До пропасти таквих, није погрешно држати их у категорији „истина“, наводних попут каквих приправника. За разлику од лажи истина је оно што траје, такође оно што би стално показивало врхунску корелацију са све више и више случајних променљивих одговарајуће мултилинеарне регресије.
Reckoning » eng
Питање: Имате ли неке стварне примере ових линеарних регресија?
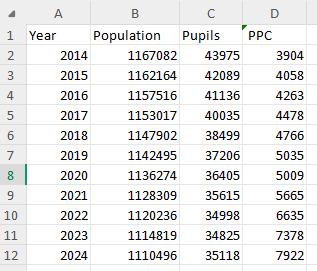
Одговор: Узмимо јавне податке статистичког завода Републике Српске, сада у CSV формату:
Year,Population,Pupils,PPC
2014,1167082,43975,3904
2015,1162164,42089,4058
2016,1157516,41136,4263
2017,1153017,40035,4478
2018,1147902,38499,4766
2019,1142495,37206,5035
2020,1136274,36405,5009
2021,1128309,35615,5665
2022,1120236,34998,6635
2023,1114819,34825,7378
2024,1110496,35118,7922
које сам похранио у датотеку teka.csv са програмом налик Ексцелу (WPS Office) и то у фолдер са Питон програмом. Као што видите, оне (Comma-Separated Values) су по годинама (Year) од 2014. до 2024, број становника (Population), укупно ученика средњих школа (Pupils) и бруто производ по становнику у еурима (PPC). Ето их на слици, горе десно.
1. За једноставне корелације, све одједном, имамо Питон програм:
import pandas as pd
df = pd.read_csv('stat.csv')
print(df.corr())
на екрану он штампа Пирсонове коефицијента корелације свих парова:
                Year  Population    Pupils       PPC
Year        1.000000   -0.995927 -0.966720  0.949583
Population -0.995927    1.000000  0.949351 -0.966436
Pupils     -0.966720    0.949351  1.000000 -0.846598
 PPC        0.949583   -0.966436 -0.846598  1.000000
Ово значи, у првом реду бројева, да година-година имају коефицијенте корелације 1,000 али година-број становника -0,996. Како године расту тако број становника опада, опада и број ученика (-0,967), али приходи по глави становника расту (0,950).
2. Налажење вишеструке регресије, прве две од Year, Population, Pupils и PPC, је тражење линеарне форме, облика y = β0 + β1⋅X1 + β2⋅X2 рецимо за y = PPC којој тражимо β0 = Intercept заједно са коефицијентима β1 и β2, а фактори су им поменуте прве независне проенљиве. Следећи програм ће поред њих наћи још понешто:
import pandas as pd
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score

data = {'Year': [2014, 2015, 2016, 2017, 2018, 2019, 2020,
                 2021, 2022, 2023, 2024],
        'Population': [1167082, 1162164, 1157516, 1153017,
                       1147902, 1142495, 1136274, 1128309,
                       1120236, 1114819, 1110496],
        'Pupils': [43975, 42089, 41136, 40035, 38499,
                   37206, 36405, 35615, 34998, 34825, 35118],
        'PPC': [3904, 4058, 4263, 4478, 4766, 5035, 5009,
                5665, 6635, 7378, 7922]}
df = pd.DataFrame(data)
print(df)
X = df[['Year', 'Population']]  # Multiple independent variables
y = df['PPC']                 # Dependent variable as a Series
X_train, X_test, y_train, y_test = train_test_split(X, y,
                        test_size=0.3, random_state=100)
model = LinearRegression()
model.fit(X_train, y_train) # Fits the model to the training data
print('Intercept:', model.intercept_)
print('Coefficients:', model.coef_)
y_pred = model.predict(X_test)
print(f"\nPredicted responses for test set: {y_pred}")
mse = mean_squared_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)
print(f"\nMean Squared Error (MSE): {mse}")
print(f"Coefficient of Determination (R-squared): {r2}")
Покретањем овог програма, на екрану излази:
    Year  Population  Pupils   PPC
0   2014     1167082   43975  3904
1   2015     1162164   42089  4058
2   2016     1157516   41136  4263
3   2017     1153017   40035  4478
4   2018     1147902   38499  4766
5   2019     1142495   37206  5035
6   2020     1136274   36405  5009
7   2021     1128309   35615  5665
8   2022     1120236   34998  6635
9   2023     1114819   34825  7378
10  2024     1110496   35118  7922
Intercept: 840802.4525575939
Coefficients: [-3.43030412e+02 -1.25276613e-01]

Predicted responses for test set: [7191.18021636
	5532.46173013 4004.20229184 5096.14633552]

Mean Squared Error (MSE): 78886.72055445887
Coefficient of Determination (R-squared): 0.9473733650695393
Дакле, коефицијенти (β0, β1, β2) су:
(840802,4525575939; -343,030412; -0,125276613)
Па по формули израчунати PPC је:
ppc14 = β0 + β1⋅2014 + β2⋅1167082 ≈ 3731 [3904], ppc15 = β0 + β1⋅2015 + β2⋅1162164 ≈ 4004 [4058], ppc16 = β0 + β1⋅2016 + β2⋅1157516 ≈ 4243 [4263], ...
У угластим заградама десно мерени су подаци PPC (Product per Capita).
3. Многе популације у свету потврђују да раст производа по становнику има супротан тренд од природог прираштаја, али то и није нешто ново. За савремени економски просперитет друштва је имати децу штетно, а природа има своје нама ретко разумљиве механизме против штеточина, а чак и страна која им не пружа отпор губи (Pest). Томе у прилог долази теорија игара ове теорије информације (Traits) са једном изненађујућом (хипо)тезом, да природа даје додатне шансе виталности. Наиме, уз већу виталност иду више, боље стратегије.
4. Ово изненађујуће откриће могли бисмо наслутити и из експеримената Калхуна (Death Squared) са мишевима. Усклађивање гура и удруживање малих живих ћелија у већа ткива, а жива бића у организације и појачава пукотине равноправних разбијајући им структуру у различитости. Како хомогена расподела има највећу информацију, тако ће и овај процес ићи спонтано уз своје претпоставке (Squared). Природа спонтано гаси систем којем није у стању да успостави разлике! Тренутно смо далеко од теме, па приметимо још само да су преуређени системи мање витални, па затим и мање репродуктивни.
Simultaneous » eng
Питање: Шта је „симултана“ метода решавања линеарних регресија?
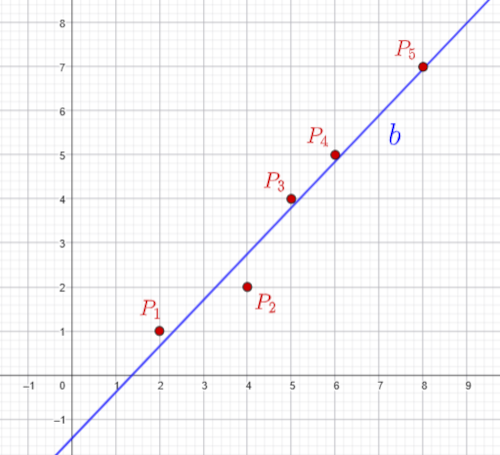
Одговор: Симултана проста или вишеструка линеарна регресија је статистичка техника која узме све предикаторске променљиве (xi) истовремено и добија модел како њиховог заједничког тако и појединачног утицаја на зависну променљиву:
y = β0 + β1x1 + ... + βmxm.
Објаснићу их на два примера, на простој и вишеструкој линеарној регресији, за m = 1 и m = 2.
1. Проста линеарна регресиија је задата са y = β0 + β1x, где је независна променљива n-торка, односно вектор x = (ξ1, ξ2, ..., ξn), такође и зависна променљива y = (η1, η2, ..., ηn) али коју изражавамо помоћу независне и параметара β0 и β1 које требамо израчунати. У наставку пишемо:
∑ y = η1 + η2 + ... + ηn, x = ξ1 + ξ2 + ... + ξn, ∑ xy = ξ1η1 + ξ2η2 + ... + ξnηn, ∑ x² = ξ1² + ξ2² + ... + ξn².
Укратко, задату регресију (y = β0 + β1x) сабирамо и, друго, множимо је са променљивом и такође сабирамо, чиме добијамо систем од две линеарне једначине са две непознате, β0 и β1, два параметра регресије. Када знамо ове (бета) параметре, онда помоћу слободних елемената x израчунавамо (процењујемо) елементе y' = β0 + β1x сматрајући грешкe ε = y' - y малима.
2. Конкретно, нека је n = 5 за регресију y = β0 + β1x множену и сабирану:
∑ y = nβ0 + β1 ∑ x, ∑ xy = β0 ∑ x + β1 ∑ x²,
са задатим елементима у прве две од колона:
| y | x | xy | x² |
|---|---|---|---|
| 1 | 2 | 2 | 4 |
| 2 | 4 | 8 | 16 |
| 4 | 5 | 20 | 25 |
| 5 | 6 | 30 | 36 |
| 7 | 8 | 56 | 64 |
| 19 | 25 | 116 | 145 |
У доњем реду су збирови колона на основу којих горњи систем постаје:
19 = 5β0 + 25β1, 116 = 25β0 + 145β1.
То је линеарни систем, α = M β, са симетричном матрицом другог реда:
$$ \begin{pmatrix} 19 \\ 116 \end{pmatrix} = \begin{pmatrix} 5 & 25 \\ 25 & 145 \end{pmatrix} \begin{pmatrix} \beta_0 \\ \beta_1 \end{pmatrix}. $$Детерминанта ове матрице је det(M) = 5⋅145 - 25² = 100, па постоји инверзни систем M-1 α = β:
$$ \begin{pmatrix} \beta_0 \\ \beta_1 \end{pmatrix} = \frac{1}{100}\begin{pmatrix} 145 & -25 \\ -25 & 5 \end{pmatrix} \begin{pmatrix} 19 \\ 116 \end{pmatrix} = \begin{pmatrix} -1,45\\ 1,05 \end{pmatrix}. $$Добили смо коефицијенте β0 = -1,45 и β1 = 1,05. Провера:
19 = 5⋅(-1,45) + 25⋅(1,05), 116 = 25⋅(-1,45) + 145⋅(1,05)
потврђује тачност резултата. Погледајмо на крају шта смо добили, тестирајући ово на датим низовима:
$$ \mathbf{\beta}_0 + \mathbf{\beta}_1\mathbf{x} = \begin{pmatrix} -1,45 + 1,05\cdot 2 \\ -1,45 + 1,05\cdot 4 \\ -1,45 + 1,05\cdot 5 \\ -1,45 + 1,05\cdot 6 \\ -1,45 + 1,05\cdot 8 \end{pmatrix} = \begin{pmatrix} 0,65 \\ 2,75 \\ 3,80 \\ 4,85 \\ 6,95 \end{pmatrix} \approx \begin{pmatrix} 1 \\ 2 \\ 4 \\ 5 \\ 7 \end{pmatrix} = \mathbf{y}. $$То је „тачност“ симултане методе просте линеарне регресије. Горе лево, слика приказује n = 5 црвених тачака P1(2, 1), P2(4, 2), P3(5, 4), P4(6, 5) и P5(8, 7) овог примера и плаву линију b симултане линеарне регресије.
3. Упоредимо овај резултат са оним што би пронашла метода најмањих квадрата. Израчунавамо средње вредности датих низова x = (2, 4, 5, 6, 8) и y = (1, 2, 4, 5, 7), то су μx = ∑ x/n = 25/5 = 5,0 и μy = ∑ y/n = 19/5 = 3,8, па формирамо спојнице и помоћу њих корелацију:
sx = x - μx = (-3, -1, 0, 1, 3), sy = y - μy = (-2,8, -1,8, 0,2, 1,2, 3,2), sx⋅sy = (-3)⋅(-2,8) + (-1)⋅(-1,8) + 0⋅0,2 + 1 ⋅1,2 + 3⋅3,2 = 21,0 κ(x, y) = sx⋅sy/[√(9 + 1 + 0 + 1 + 9)(7,83 + 3,24 + 0,04 + 1,44 + 10,24)], κ(x, y) = 21/(4,47⋅4,77), κ(x, y) = 0,98.
Линеарна регресија најмањих квадрата има формулу y = a + bx, где је:
b = 0,98⋅4,77/4,47 = 1,05, a = 3,8 - 1,05⋅5 = -1,45
приближно. Тако добијамо линију регресије методом најмањих квадрата:
y = -1,45 + 1,05 x
а то је и линија регресије симултаном методом, коју смо израчунали пре овога.
4. После свега погледајмо и један лаган пример симултане вишеструке линеарне регресије y = β0 + β1 x1 + β2 x2, са збировима таблично:
| y | x1 | x2 | x1y | x1² | x1x2 | x2y | x2² |
|---|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 2 | 4 | 6 | 3 | 9 |
| 2 | 4 | 5 | 8 | 16 | 20 | 10 | 25 |
| 4 | 5 | 10 | 20 | 25 | 50 | 40 | 100 |
| 5 | 6 | 11 | 30 | 36 | 66 | 55 | 121 |
| 7 | 8 | 13 | 56 | 64 | 104 | 91 | 169 |
| 19 | 25 | 42 | 116 | 145 | 246 | 199 | 424 |
Ово нам треба, јер једначину линеарне регресије множимо са првом, па другом променљивом да добијемо систем три линеарне једначине:
∑ y = n β0 + β1 ∑ x1 + β2 ∑ x2, ∑ x1y = β0 ∑ x1 + β1 ∑ x1² + β2 ∑ x1x2, ∑ x2y = β0 ∑ x2 + β1 ∑ x1x2 + β2 ∑ x2².
Збирови (дно табеле) дају линеарне једначине непознатих β0, β1 и β2:
19 = 5 β0 + 25 β1 + 42 β2, 116 = 25 β0 + 145 β1 + 246 β2, 199 = 42 β0 + 246 β1 + 424 β2.
То је линеарни систем, α = M β, са симетричном матрицом трећег реда, који ћемо промене ради сада решити методом елиминације. Множимо прву од три једначине са -5, па резултат саберимо са другом; множимо прву са -42/5 па је саберимо са трећом; добијамо:
21 = 20 β1 + 36 β2, 197 = 180 β1 + 356 β2.
Ово је линеарни систем две једначнине. Множимо прву са -9 и саберимо их, добијамо 8 = 32 β2 и отуда:
β2 = 1/4 = 0,25.
Вратимо ово у прву претходну једначину, 21 = 20 β1 + 36/4, па налазимо да је 3 = 5 β1 и отуда:
β1 = 3/5 = 0,6.
Вратимо оба нађена параметра у саму прву једначину, излази:
19 = 5 β0 + 25⋅3/5 + 42/4, -13 = 10 β0, β0 = -13/10 = -1,3.
Према томе, је:
y = β0 + β1 x1 + β2 x2,
y = -1,3 + 0,6 x1 + 0,25 x2
раван линеарне регресије у правоуглом систему yx1x2 коју смо налазили симултаном методом.
Coincident » eng
Питање: Шта је предност „симултане“ методе линеарних регресија?
Одговор: Једноставност, ако је то нека предност за статистичаре и друге кориснике ових метода. То, пре свега, јесте корист за послове теоретичара, а евентуално за још неке, рецимо, да примете када та регресија неће успевати. Прошли одговор је лако поопштити.
1. Једначину дате мултилинеарне регресије сада запишимо у облику са малим x-овима (обично су велика, са малим y) и уведимо m-торку x0 = (1, 1, ..., 1) која иначе не постоји:
y = β0x0 + β1x1 + ... + βnxn,
где су елементи m-торки xk = (ηjk) реални или комплексни бројеви. Тада формирамо системе линеарних једначина скаларним множењима:
$$ \langle x_j|y\rangle = \sum_{k=0}^n \beta_k \langle x_j|x_k\rangle, \quad j = 0, 1, ..., n. $$Исти писани матрично (α = M β) су:
$$ \begin{pmatrix} \langle x_0|y\rangle \\ \langle x_1|y\rangle \\ ... \\ \langle x_n|y\rangle \end{pmatrix} = \begin{pmatrix} \langle x_0|x_0\rangle & \langle x_0|x_1 \rangle & ... & \langle x_0|x_n\rangle \\ \langle x_1|x_0\rangle & \langle x_1|x_1 \rangle & ... & \langle x_1|x_n\rangle \\ ... & ... & ... & ... \\ \langle x_n|x_0\rangle & \langle x_n|x_1 \rangle & ... & \langle x_n|x_n\rangle \end{pmatrix} \begin{pmatrix} \beta_0 \\ \beta_1 \\ ... \\ \beta_n \end{pmatrix}, $$где су сви коефицијенти познати осим ови десно, вектора бета. Да би се нашао вектор бета, потребна је регуларна матрица M, што повлачи да је њена детерминанта det(M) ≠ 0, односно да можемо писати β = M-1α. Али ово значи да су вектори xk међусобно линеарно независни.
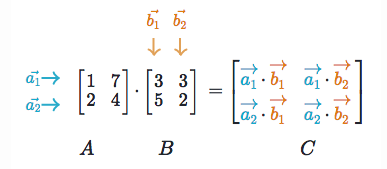
На слици лево на једноставном примеру видимо једну матрицу, ознаке C, скаларних производа вектора. Настаје множењем две матрице, AB = C. Поред тога, зна се да је детерминанта производа det(AB) једнака (det A) (det B). А отуда су и вектори xk међусобно линеарно независни акко det(M) ≠ 0.
2. У прошлом одговору (Simultaneous, 4) била је и матрица (3 × 3) која је прво у општем облику, са можда и комплексним коефицијентима, где се подразумевају вектори-колоне:
$$ X^\dagger X = M, $$ $$ \begin{pmatrix} x_0^\dagger \\ x_1^\dagger \\ x_2^\dagger \end{pmatrix} \begin{pmatrix} x_0 & x_1 & x_2 \end{pmatrix} = \begin{pmatrix} \langle x_0|x_0\rangle & \langle x_0|x_1\rangle & \langle x_0|x_2\rangle \\ \langle x_1|x_0\rangle & \langle x_1|x_1\rangle & \langle x_1|x_2\rangle \\ \langle x_2|x_0\rangle & \langle x_2|x_1\rangle & \langle x_2|x_2\rangle \end{pmatrix}, $$ $$ \begin{pmatrix} 1 & 1 & 1 & 1 & 1 \\ 2 & 4 & 5 & 6 & 8 \\ 3 & 5 & 10 & 11 & 13 \end{pmatrix} \begin{pmatrix} 1 & 2 & 3 \\ 1 & 4 & 5 \\ 1 & 5 & 10 \\ 1 & 6 & 11 \\ 1 & 8 & 13 \end{pmatrix} = \begin{pmatrix} 5 & 25 & 42 \\ 25 & 145 & 246 \\ 42 & 246 & 424 \end{pmatrix}. $$Лево нису квадратне матрице и оне немају детерминанте, али њихови делови који су квадратне матрице имају их и оне су различите од нуле. Детерминанта ове матрице је det(M) = 640, а инверзна:
$$ M^{-1} = \begin{pmatrix} 1,50625 & -0,41875 & 0,09375 \\ -0,41875 & 0,55625 & -0,28125 \\ 0,09375 & -0,28125 & 0,15625 \end{pmatrix} $$па из линеарног система, $\vec{\alpha} = M\vec{\beta}$, знајући алфе налазимо бете:
$$ \vec{\beta} = M^{-1}\vec{\alpha}, $$ $$ \begin{pmatrix} \beta_0 \\ \beta_1 \\ \beta_2 \end{pmatrix} = \begin{pmatrix} 1,50625 & -0,41875 & 0,09375 \\ -0,41875 & 0,55625 & -0,28125 \\ 0,09375 & -0,28125 & 0,15625 \end{pmatrix} \begin{pmatrix} 19 \\ 116 \\ 199 \end{pmatrix}, $$ $$ \begin{pmatrix} \beta_0 \\ \beta_1 \\ \beta_2 \end{pmatrix} = \begin{pmatrix} -1,3 \\ 0,6 \\ 0,25 \end{pmatrix}, $$а исто је, на други начин, добијено у поменутом одговору.
3. Вишеструка линеарна регресија је начин да се каже: „Покушавамо да предвидимо нешто на основу гомиле различитих фактора.“ На пример, када код прављења смутија, или гушћег густог воћног напитка, сваки од састојака (банана, јогурт, мед) додаје нешто коначном укусу. Сваки Xk (за k = 1, 2, ..., n) као независна променљива, називан предиктор, доприноси предвиђању исхода, или зависне променљиве y = β0 + β1X1 + ... + βnXn. А сваки пут када сипамо исте састојке, рецимо правећи смути, очекујемо да добијемо исти укус напитка — мада су састојци међусобно независни. Ово је веома важно за разумевање очекивања излаза и независности улаза.
4. Предност симултане методе види се и том случају, што свака ермитска (симетрична) матрица M има реалне својствене вредности λ ∈ ℝ а којима припадају својствени вектори $\vec{v}$ тако да је $M\vec{v} = \lambda\vec{v}$. Деси ли се да је такав својствени вектор управо бета, $M\vec{\beta} = \lambda\vec{\beta}$, биће $\lambda\vec{\beta} = \vec{\alpha}$, па све координате вектора алфа постају скаларни производи редом независних са зависном променљивом, $\vec{\alpha} = (\langle \vec{x}_k|\vec{y}\rangle)$ са k = 0, 1, ..., n. Стављам стрелице изнад ових m-торки да нагласим њихову векторску природу.
Другим речима, догоди ли се током мерења случајних исхода $\vec{x}_k = (\xi_{jk})$, где ξjk ∈ ℂ када j = 1, 2, ..., m и k = 0, 1, ..., n, да они дају управо својствени вектор $\vec{\beta}$ матрице $M = (\langle x_j|x_k\rangle)$ реда n+1, тада ће елементи $\langle \vec{x}_k|\vec{y}\rangle = \lambda\beta_k$ вектора алфа бити пројекције независних случајних променљивих $\vec{x}_k$ на зависну променљиву $\vec{y}$. Без обзира деси ли се такво што датим мерењем, симултана метода открива ту могућност као увек присутну, латантну, па и саму логику поменутог очекивања (укуса од независних додатака).
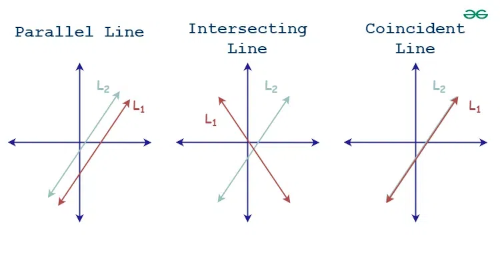
5. Коинциденција (поклапање, истовременост) у статистици има помало ишчашено, померено значење у односу на геометријско (в. слику и линк, горе десно). Као у дилеми шта је пре настало, кокош или јаје, код теорије информације о којој расправљамо, то је питање првенства случајности и узрочности. Доследно, држим се приоритета случајности из које помоћу стварности (опажљива, одржива, истинита) понављањем и законитошћу великих бројева настаје узрочност. Матрице попут M и њима описивани процеси или слично, такође говоре о локалној дивергенцији и глобалној конвергенцији.
Least squares II » eng
Питање: Где да нађем доказ методе „најмањих квадрата“ за вишеструку линеарну регресију?
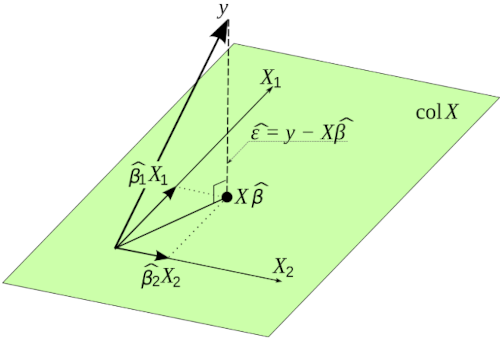
Одговор: Имате о томе на линку слике лево. Верујем да је и боље од онога што вам тренутно могу испричати. Али, ево, па бирајте.
Заједничка у рачуну просте или вишеструке линеарне регресије је почетна формула:
y = β0 + β1X1 + ... + βnXn
где је n = 1, 2, 3, ..., вектори Xk = (ξ1k, ξ1k, ..., ξmk) сви су m-торке бројева којима имам обичај додати само још једну такву X0 = (1, 1, ..., 1) ради згоднијег даљег писања.
1. Матрично, y = Xb, са векторима, једном m-торком y = (η1, η2, ..., ηm) и n+1-торком b = (β0, β1, ..., βn), то пишемо:
$$ \begin{pmatrix} \eta_1 \\ \eta_2 \\ ... \\ \eta_m \end{pmatrix} = \begin{pmatrix} 1 & \xi_{11} & ... & \xi_{1n} \\ 1 & \xi_{21} & ... & \xi_{2n} \\ ... & ... & ... & ... \\ 1 & \xi_{m1} & ... & \xi_{mn} \end{pmatrix} \begin{pmatrix} \beta_0 \\ \beta_1 \\ ... \\ \beta_n \end{pmatrix}. $$Препознајемо ову матрицу из једначине $X^\dagger X = M$ претходног одговора (Coincident, 2). Иначе, адјунговање X† је коњуговање са транспоновањем матрице X, али у статистици која користи само реалне бројеве оно је само транспоновање, X† = (X*)⊤ = X⊤. То је полазни облик из стварног мерења. Зависна променљива коју би дала формула је низ $\hat{y} = (\hat{\eta}_1, \hat{\eta}_2, ..., \hat{\eta}_m)$, са грешком e = y - ŷ такође вектором, m-торком e = (ε1, ε2, ..., εm) при чему је $\varepsilon_j = \eta_j - \hat{\eta}_j$ за свако j = 1, 2, ..., m.
2. У претходном одговору нашли смо једно решење вишеструке линеарне регресије. Оно се заснива на скаларним производима (низова) случајних променљивих, или на њиховој унутрашњој информацији (In and Out) док сада тражимо решење за минималну вредност збира квадрата:
$$ E = \|e\|^2 = \langle e|e\rangle = (\eta_1 - \hat{\eta})^2 + (\eta_2 - \hat{\eta}_2)^2 + ... + (\eta_m - \hat{\eta}_m)^2. $$Ова „функција грешке“ матрично писана је:
$$ E = e^\dagger e = (y - \hat{y})^\dagger (y - \hat{y}) = (y^\dagger - \hat{y}^\dagger)(y - \hat{y}) = $$ $$ = [y^\dagger - (Xb)^\dagger][y - (Xb)] = y^\dagger y - y^\dagger (Xb) - (Xb)^\dagger y + (Xb)^\dagger(Xb), $$ $$ Е = y^\dagger y - 2y^\dagger(Xb) + b^\dagger Mb. $$Приметили смо да је последњи сабирак (Xb)†(Xb) = b†X†Xb = b†Mb, где је M симетрична, она је уопште и ермитска M† = M, матрица из претходног одговора. Поред тога, други и трећи сабирак једнаки су у случау реалних коефицијената, y†(Xb) = (Xb)†y.
3. Други и трећи сабирак реалних коефицијената једнаки су. Наиме, овај други сабирак можемо написати у облику:
$$ y^\dagger(Xb) = \begin{pmatrix} \eta^*_1 & \eta^*_2 & \dots & \eta^*_m \end{pmatrix} \begin{pmatrix} \beta_0 + \xi_{11}\beta_1 + ... + \xi_{1n}\beta_n \\ \beta_0 + \xi_{21}\beta_1 + ... + \xi_{2n}\beta_n \\ \dots \\ \beta_0 + \xi_{m1}\beta_1 + ... + \xi_{mn}\beta_n \end{pmatrix} = $$ $$ = \beta_0\sum^m_{j=1} \eta^*_j + \beta_1\sum^m_{j=1} \eta^*_j \xi_{j1} + ... + \beta_n \sum^m_{j=1} \eta^*_j \xi_{jn} = \sum_{k=0}^n \sum_{j=1}^m \beta_k \eta_j^* \xi_{jk} $$ $$ y^\dagger(Xb) = \sum_{k=0}^n \beta_k \langle y | X_k \rangle. $$То је други поменути сабирак, а због краћег писања поново (као у претходном одговору) увели смо помоћни низ X0 = (1, 1, ..., 1) са m јединица. Трећи сабирак је:
$$ (Xb)^\dagger y = \begin{pmatrix} \beta_0 + \xi_{11}\beta_1 + ... + \xi_{1n}\beta_n \\ \beta_0 + \xi_{21}\beta_1 + ... + \xi_{2n}\beta_n \\ \dots \\ \beta_0 + \xi_{m1}\beta_1 + ... + \xi_{mn}\beta_n \end{pmatrix}^\dagger \begin{pmatrix} \eta_1 \\ \eta_2 \\ \dots \\ \eta_m \end{pmatrix} = $$ $$ = \beta^*_0 \sum^m_{j=1} \eta_j + \beta^*_1\sum^m_{j=1} \xi^*_{j1}\eta_j + ... + \beta^*_n\sum^m_{j=1} \xi^*_{jn}\eta_j = \sum_{k=0}^n\sum_{j=1}^n \beta_k^*\xi_{jk}^* \eta_j $$ $$ (Xb)^\dagger y = \sum_{k=0}^n \beta^*_k\langle X_k | y\rangle. $$Међутим, ако су коефицијенти реални бројеви, када је свако $\beta^*_k = \beta_k$ и $\xi_{jk}^* = \xi_{jk}$, биће и свако ⟨y|Xk⟩ = ⟨Xk|y⟩, па је y†(Xb) = (Xb)†y.
4. Када већ детаљишем са овим извођењем, застанимо да вам докажем и (иначе познати) став за матричне изводе ∂x(x⊤Ax) = x⊤(A + A⊤), вектора и матрице, x = (ξ1, ..., ξm)⊤ и A = (αjk) са j = 1, 2, ..., m и k = 0, 1, ..., n, реалних коефицијената. Имамо редом:
$$ f = x^\top Ax = \sum_{j=1}^m\sum_{k=0}^n \alpha_{jk}\xi_j\xi_k, $$ $$ \frac{\partial f}{\partial \xi_i} = \sum_{k=0}^n \alpha_{ik}\xi_k + \sum_{j=1}^m \alpha_{ji}\xi_j $$ $$ \frac{\partial f}{\partial x} = x^\top A^\top + x^\top A = x^\top (A^\top + A) $$а то смо и хтели доказати. Наши коефицијенти (2) су реални бројеви, па тражећи најмањи збир квадрата користећи претходно потражимо извод „функције грешке“ E да бисмо га затим изједначили са нулом.
5. Тражимо извод збира квадрата (E) да бисмо га изједначили са нулом и нашли стационарну тачку међу којима је његова минимална вредност:
$$ \frac{\partial Е}{\partial b} = \frac{\partial}{\partial b}[y^\top y - 2y^\top(Xb) + b^\top Mb] = -2y^\top X + 2(X^\top X) b^\top = 0, $$ $$ (X^\top X)b^\top = y^\top X, $$ $$ b^\top = (y^\top X)(X^\top X)^{-1}, $$ $$ b = [(y^\top X)(X^\top X)^{-1}]^\top, $$ $$ b = [(X^\top X)^{-1}]^\top (y^\top X)^\top, $$ $$ b = (X^\top X^{-1})(X^\top y). $$То је формула вишеструке линеарне регресије са доказом који ћете наћи и у горњем линку, овде са појашњењима.
MLR Examples » eng
Питање: Можете ли ми навести неки пример решавања овом формулом мулти-линеарне регресије (Least squares II, 5)?
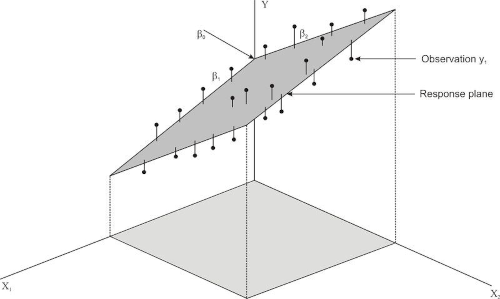
Одговор: Примера за тестирање имате и на линку слике десно, а овде ћу показати саму употребу те формуле, b = (X⊤X-1)(X⊤y). Ту је b = (β0, β1, ..., βn), а матрица X за прву колону има јединице, па колоне-векторе X1, ..., Xn сваки је m-торка реалних бројева. Када је n = 2 имамо 3-дим простор налик слици десно. Тачака Pj(ξj1, ξj2, ηj) има m, где j = 1, 2, ..., m. Када је n = 1 то је 2-дим простор. Узећу за пример таквог први из недавног одговора (Simultaneous, 2), ради лакшег учења.
1. Измерени су 5-члани низови случајних променљивих x1 = (2, 4, 5, 6, 8)⊤ и y = (1, 2, 4, 5, 7)⊤ које даље третирамо као векторе-колоне. Овде је n = 1 и у n+1 = 2-дим простору тражимо једначину праве ŷ = β0x0 + β1x1 такву да у смислу „најмањих квадрата“ најбоље апроксимира тачке (2, 1), (4, 2), (5, 4), (6, 5) и (8, 7) њима одређене. Тражимо вектор „бета“, b = (β0, β1)⊤, а додали смо вектор x0 = (1, 1, 1, 1, 1,) да дефинишемо матрице X⊤X = M:
$$ \begin{pmatrix} 1 & 1 & 1 & 1 & 1 \\ 2 & 4 & 5 & 6 & 8 \end{pmatrix} \begin{pmatrix} 1 & 2 \\ 1 & 4 \\ 1 & 5 \\ 1 & 6 \\ 1 & 8 \end{pmatrix} = \begin{pmatrix} 5 & 25 \\ 25 & 145 \end{pmatrix} $$које нам требају за рачунање вектора „бета“ према формули „најмањих квадрата“:
b = (X⊤X-1)(X⊤y) = [(X⊤X)-1]⊤(X⊤y) =
$$ = [(\begin{pmatrix} 1 & 1 & 1 & 1 & 1 \\ 2 & 4 & 5 & 6 & 8 \end{pmatrix} \begin{pmatrix} 1 & 2 \\ 1 & 4 \\ 1 & 5 \\ 1 & 6 \\ 1 & 8 \end{pmatrix})^{-1}]^\top (\begin{pmatrix} 1 & 1 & 1 & 1 & 1 \\ 2 & 4 & 5 & 6 & 8 \end{pmatrix} \begin{pmatrix} 1 \\ 2 \\ 4 \\ 5 \\ 7 \end{pmatrix}) $$ $$ = [\begin{pmatrix} 5 & 25 \\ 25 & 145 \end{pmatrix}^{-1}]^\top \begin{pmatrix} 19 \\ 116 \end{pmatrix} $$ $$ = \begin{pmatrix} 1,45 & -0,25 \\ -0,25 & 0,05 \end{pmatrix}^\top \begin{pmatrix} 19 \\ 116 \end{pmatrix} $$ $$ = \begin{pmatrix} 1,45 & -0,25 \\ -0,25 & 0,05 \end{pmatrix} \begin{pmatrix} 19 \\ 116 \end{pmatrix}, $$ $$ b = \begin{pmatrix} -1,45 \\ 1,05 \end{pmatrix} = \begin{pmatrix} \beta_0 \\ \beta_1 \end{pmatrix}. $$Дакле, најбоља апроксимација датих пет тачака, ова методом „најмањих квадрата“, је права ŷ = -1,45 + 1,05⋅x и то је идентична линеарна регресија коју смо добили радећи на другачији начин.
2. Други пример је такође из поменутог одговора. Задатe случајне 5-орке, независне променљиве x1 = (2, 4, 5, 6, 8)⊤ и x2 = (3, 5, 10, 11, 13)⊤ и зависна y = (1, 2, 4, 5, 7)⊤ са којима тражимо раван ŷ = β0x0 + β1x1 + β2x2 која дате тачке (2, 3, 1), (4, 5, 2), (5, 10, 4), (6, 11, 5) и (8, 13, 7) апроксимира начином најмањих квадрата. Тражимо вектор b = (β0, β1, β2)⊤ горњом формулом:
b = (X⊤X-1)(X⊤y) = [(X⊤X)-1]⊤(X⊤y) =
$$ = [(\begin{pmatrix} 1 & 1 & 1 & 1 & 1 \\ 2 & 4 & 5 & 6 & 8 \\ 3 & 5 & 10 & 11 & 13 \end{pmatrix} \begin{pmatrix} 1 & 2 & 3 \\ 1 & 4 & 5 \\ 1 & 5 & 10 \\ 1 & 6 & 11 \\ 1 & 8 & 13 \end{pmatrix})^{-1}]^\top (\begin{pmatrix} 1 & 1 & 1 & 1 & 1 \\ 2 & 4 & 5 & 6 & 8 \\ 3 & 5 & 10 & 11 & 13 \end{pmatrix} \begin{pmatrix} 1 \\ 2 \\ 4 \\ 5 \\ 7 \end{pmatrix}) $$ $$ = [\begin{pmatrix} 5 & 25 & 42 \\ 25 & 145 & 246 \\ 42 & 246 & 424 \end{pmatrix}^{-1}]^\top \begin{pmatrix} 19 \\ 116 \\ 199 \end{pmatrix}. $$Матрица M = X⊤X је симетрична, M⊤ = M. Њена детерминанта је det M = 640, што значи да има инверзну матрицу M-1, такође симетричну, чији је производ са M јединична матрица. Даље је:
$$ b = \begin{pmatrix} \beta_0 \\ \beta_1 \\ \beta_2 \end{pmatrix} = \begin{pmatrix} 1,50625 & -0,41875 & 0,09375 \\ -0,41875 & 0,55625 & -0,28125 \\ 0,09375 & -0,28125 & 0,15625 \end{pmatrix} \begin{pmatrix} 19 \\ 116 \\ 199 \end{pmatrix}, $$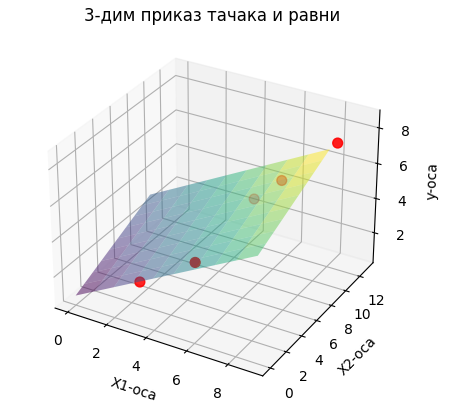
Опет, најбоља је апроксимација нових просторних пет тачака, са формулом „најмањих квадрата“, раван ŷ = -1,3 + 0,6⋅x1 + 0,25⋅x2 на слици лево. То је та вишеструка-линеарна регресија израчуната и раније (Simultaneous, 4), када смо је пронашли на другачији начин. Надам се да је метода разумљива (бар ономе ко ми је тражио), али и колико се њих две на крају не разликују.
3. Следећи програм (Python, 3.11.0) црта претходни граф:
import numpy as np
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D

# Једначина ax + by + cz + d = 0 има вектор нормале [a, b, c]
normal = np.array([0.6, 0.25, -1])
# Пресечна тачка равни и апликате (x1 = 0, x2 = 0, y = -1.3)
point = np.array([-1.3, 0, 0])
d = -point.dot(normal) # Удаљеност равни од исходишта

# Креира систем координата за равнину
x1, x2 = np.meshgrid(range(10), range(10))
y = (-normal[0] * x1 - normal[1] * x2 - d) * 1. / normal[2]

# Дефинише дате тачке
points_to_plot = np.array([[2, 3, 1], [4, 5, 2], [5, 10, 4],
			   [6, 11, 5], [8, 13, 7]])

# Прави 3-дим графикон
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')

# Црта раван и тачке
ax.plot_surface(x1, x2, y, alpha=0.5, cmap='viridis')
ax.scatter(points_to_plot[:, 0], points_to_plot[:, 1],
		points_to_plot[:, 2], color='red', s=50)

# Поставља ознаке и наслов
ax.set_xlabel('X1-оса')
ax.set_ylabel('X2-оса')
ax.set_zlabel('y-оса')
ax.set_title('3-дим приказ тачака и равни')

plt.show()
Овакве програме иначе држим у модулима, попут кодова, са уједначеним улазима и излазима да би се надовезивали као Лего коцкице.
4. Фантастично је поучна ова особина више-линеарних регресија да имају ширине, истинске различитости које постижу исто. На пример, могуће је имати дату тежину (y) ако сте мршави и високи (X1), или када сте дебели и ниски (X2). Она се тиче распрострањености апстрактних појава и стоји насупрот јединствености конкретних (Riesz Lemma). То је заправо појава који ме више занима од ових статистичких израчунавања, али таква овде није тема.
Errors » eng
Питање: Како оцењивати грешке које прави линеарна регресија?
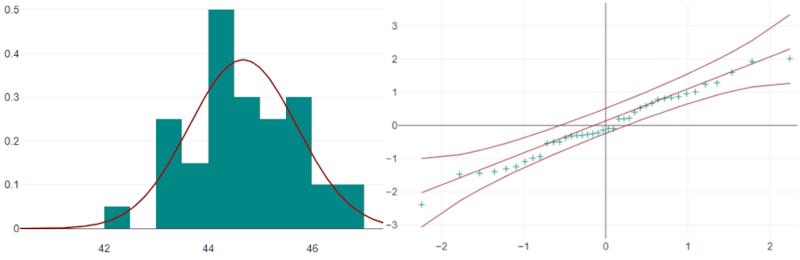
Одговор: Узмимо претходне примере да дефинишемо проблем. Прво је била проста линеарна регресија. Она је тачкама (x, y) ∈ (2, 1), (4, 2), (5, 4), (6, 5) и (8, 7) давала ординате ŷ(x) = -1,45 + 1,05⋅x. Израчунавамо тачку по тачку ордината и одузимамо их од датих вредности:
ŷ(2) = 0,65 ŷ(4) = 2,75 ŷ(5) = 3,8 ŷ(6) = 4,85 ŷ(8) = 6,95; y(2) = 1 y(4) = 2 y(5) = 4 y(6) = 5 y(8) = 7; ε(2) = 0,35 ε(4) = -0,75 ε(5) = 0,2 ε(6) = 0,15 ε(8) = 0,05.
1. Грешке ε(x) мале су и уједначене. Дате тачке су близу линије регресије и то је добар указатељ за нормалну расподелу, која је иначе предуслов за примену ове регресије. Мада је пет датих тачака недовољан број за добар узорак, може послужити за обуку.
2. Замислимо ли да случајних тачака има више и да њихова одступања од наше процене формирају хистограм (леви део горње слике) који одговара црвеној звонастој линији Гаусове (1809), нормалне расподеле. Та линија је граф функције густине вероватноће:
$$ f(x) = \frac{1}{\sqrt{2\pi\sigma^2}}\exp\left(-\frac{x-\mu}{2\sigma^2}\right). $$Врх звона је изнад апсцисе очекивања μ, у случају много тачака средње грешке μ = 0, а ширине звона одређене кореном варијансе σ. Начелно, расподела вероватноће је нормална ако су подаци једнако, симетрично распоређени око централне средње вредности. То није случај грешака процена тачака које следе криву линију.
3. Симетрије значе законе одржања. Ово је међу првима установила Ема Нетер (Приче о Информацији, стр. 29), а то овде примењујемо једнако на информацију (Физичка Информација, Теорема 2.4.16, стр. 65) нормалне расподеле SN = ln√(2πeσ²) и на став да таква расподела има максималну информацију за дату дисперзију (Екстреми, 1.7). То троје откриваће једну незваничну особину нормалне расподеле, да на себе прими максималну информацију (количину неизвесности) и отклони од физичке реалности њено сувишно присуство, у складу са начелом минимализма. Говорим о делу (моје) теорије информације која још увек није присутна у науци, па према томе, који можете и занемарити.
4. Пишем ово 06.02.2026. не да бисте поверовали него да се евентуално касније позивам на следећу (хипо)тезу. Свако праволинијско кретање и апстрактне праве линије, на крају произилазе из начела минимализма и поменуте особине нормалне расподеле да апсорбује максимум количине информације дате варијансе σ². Тада су грешке мерења „лево и десно“ од процењеног правца приближно симетрично распоређене. Заправо, зато се и показују таквима, мерена физикалним начинима.
|
|
|