|
|
|


Coin flip » eng
Питање: Може ли се сваки случајни догађај свести на пола-пола истих шанси?
Одговор: Занимљиво питање и, уосталом, зато сам га уврстио у ове одговоре. Знам да је било у неком разговору, али ко то зна када, у којем тачно, или каквим поводом. Бар две су ствари које иду ка позитивном одговору на ово питање: стварност случаја и њен начелни минимализам. Но, има тога још што ову тему чини занимљивијом.
1. Стварност не воли једнакост. Парафразирам једну од важних последица начела минимализма, опет, по ко зна који пут, јер још увек то није део званичне науке.
На пример, фер новчић, вероватноћа Pr(„писмо“) = Pr(„глава“) = 1/2, има Шенонову информацију:
$$ S_1 = -\frac12\ln \frac12 - \frac12\ln \frac12 = \frac12\ln 2 + \frac12\ln 2 = \ln 2 \approx 0,69, $$док би нефер рецимо вероватноћа Pr(„писмо“) = 3/4 и Pr(„глава“) = 1/4 имао такву информацију:
$$ S_2 = -\frac34\ln \frac34 - \frac14\ln \frac14 \approx 0,56. $$У другом случају „писмо“ је вероватнији исход и мања је вест када се оно деси, па је мања неизвесност код бацања таквог (нефер) новчића и мању информацију нам доноси реализација таког догађаја. Природа спонтано тежи чешћим реализацијама вероватнијих исхода, мање неизвесним, те мање информативним, што значи да је у природи стварности и спонтана тежња мање информативним исходима. То је начело минимализма. Оно затим уопште спонтано води стварност ка поменутој неједнакости.
2. Зна се да је Шенонова информација мера исте количине неизвесности пре реализације као и информације након. На пример, вероватноћа броја „шест“ пре бацања фер коцке била је 1/6, па је та количина неизвесности:
$$ S = -\frac16\ln\frac16 - ... - \frac16\ln\frac16 = 6\cdot(\frac16\ln 6) = \ln 6 \approx 1,79 $$а то је једнако и информацији исхода. Одвојено гледано, она је једнака и Хартлијевој информацији таквог исхода, $H = \ln 6$, шест једнаких шанси. То говори о одржању количине неизвесности током саме реализације, па и о немогућности реализације више таквих исхода одједном у реалности, односно трајних, опажљивих и истинитих догађаја. Међутим, ми немамо гаранције да ће такви (фиктивни) догађаји опстати након или настати из ничега пре опита. Штавише, имамо лажи које су баш такве: непостојане и мртвој физичкој природи неопажљиве.
Ово је један од разлога да поједини временски ток сматрамо актуелном стварношћу, без искључивања могућности паралелних сличних псеудо-актуелних токова, других димензија времена. Какав год био начин да се искристалисала нека таква реалност, дати временски ток догађаја, иста има проблем са начелним минимализмом. Њене информације би хтеле нестајати, али морају опстајати. Постају, пак, још један од повода за тезу о бесконачном (континуум, или већи) резервоар могућности достатан да искристалише овакву одрживост наше васионе, која му је „проблем“.
3. Најдубља неизвесност била би она са једнаким шансама, али видели смо да је она заправо непожељна. Са друге стране знамо, информације стварности долазе у пакетима. Отуда и начин формирања рационалних вероватноћа, облика m/n, где је m ∈ {0, 1, ..., n} и n ∈ ℕ, када имамо скуп једнако-вероватних n, али у пакету са таквих m. Додатно постоје и даљи непребројиво бесконачни резервоари другачијих могућности, али не као физичке информације, односно недоступне мерењима класичне физике.
4. Приметимо да описи „реалних“ појава као перцептибилних, одрживих и истинитих не искључују математичке апстракције, па стога „стварност“ не можемо ограничавати само на оно што можемо видети, опипати, или појести, већ и на оно (не све) о чему можемо размишљати. У том смислу се сви случајни догађаји дају сводити на пола-пола истих шанси, стварни на рационалне бројеве интервала [0, 1] и уопште на реалне отуда.
Indicator II » eng
Питање: Може ли фреквенција светлости бити било који реалан број и како, евентуално, да то избегнем, да фреквенцију рачунам дискретном?
Одговор: У теорији, фреквенција светлости (или електромагнетног зрачења) је континуум величина које могу да поприме било какву позитивну реалну вредност, нису ограничене на дискретне скупове бројева. За разлику од енергија у атому, квантизованих, слободни фотони електромагнетног поља узимају континуиране вредности спектра фреквенција. Кажем суздржано, јер постоје идеје ограничавања трајања на Планково време tP ≈ 5,391×10-44 s (Graviton II). То је време за које светлост брзине c ≈ 300 000 km/s пређе пут ℓP ≈ 1,616×10-35 m, једну Планкову дужину.
1. Фреквенције видљиве светлости су од приближно 400 THz (црвена) до 790 THz (љубичаста). Оне одговарају таласним дужинама од 750 до 380 нанометара (nm). У том распону људи углавном разликују до седам боја (љубичаста, плава, цијан, зелена, жута, наранџаста, црвена). Ми можемо разликовати отприлике милион боја, али процењује се да птице опажају и до 100 милиона боја, јер су тетрахроматске. Птичије очи имају четири врсте ћелија конуса за боје (црвену, зелену, плаву и ултраљубичасту).
Иначе, један тетра-херц (1 THz) има 1012 херца (Hz), а један херц је један циклус у секунди (s), па је распон нама видљиве светлости приближно од 1,3×10⁻¹⁵ s до 2,5×10⁻¹⁵ s. У том распону (1,2 ×10⁻¹⁵ s) има места за више од 2×1028 Планкових времена. Зато ни животиње најбољег вида не опажају евентуалну дискретност фреквенција светлости, јер је она и најтачнијим уређајима данас занемарљива.
2. Па и без (хипо)тезе о Планковом времену има смисла апроксимирати „дискретну“ фреквенцију светлости континуалном, јер уосталом нешто слично често радимо обрнуто. За прву руку, покушајте са индикаторима. На пример, нека је p ∈ (0, 1) вероватноћа да се догоди A (падање „писма“ бацањем новчића, падање „шестице“ бацањем коцке итд.) и вероватноћа q = 1 - p да се не догоди A. Тада је вероватноћа догађаја A, по први пут у n-том циклусу, Pn = qn-1p. Низ P1, P2, P3, ..., је добро дефинисана расподела вероватноћа, јер је одређен независним исходима, позитивних је бројева, а збир свих је један.
3. О индикаторима сам писао у књизи Физичка информација (стр. 68-77) где ћете наћи доказе многих занимљивих теорема од којих ћу сада само неке поменути. Очекивање броја покушаја до првог жељеног догађаја је μ1 = 1/p. Варијанса броја покушаја те расподеле је σ1² = q/p². Шенонова информација такве расподеле је:
$$ S_1 = -\sum_{k=0}^\infty P_k\ln P_k = -\sum_{k=0}^\infty q^kp\ln q^kp = $$ $$ = -\sum_{k=0}^\infty q^kp(k\ln q + \ln p) = -p\sum_{k=0}^\infty (kq^k\ln q + q^k \ln p) $$ $$ = -p \ln q \, \sum_{k=0}^\infty kq^k - p\ln p\,\sum_{k=0}^\infty q^k $$ $$ = -p\ln q\,\frac{q}{(1-q)^2} - p\ln p \, \frac{1}{1-q}, $$ $$ S_1 = \frac{1}{p}(-p\ln p - q\ln q). $$У тој књизи је ово и физичка информација, L1 = S1, која је тако називана због неприкривеног закона одржања које се на њу односи.
4. Вероватноће покушаја до другог жељеног догађаја су:
P2 = p², P3 = 2p²q, P4 = 3p²q², ..., Pn = (n - 1)p²qn-2, ...
Ово је друга опет добро дефинисана расподела вероватноћа. Очекивање броја покушаја те расподеле, другог жељеног догађаја је μ2 = 2/p = 2μ1, а варијанса σ2² = 2q/p² = 2σ1². Физичку информацију покушаја до другог жељеног догађаја (L2), разликујемо је од Шенонове (S2), и она је:
$$ L_2 = -\sum_{n=2}^\infty (n-1)q^{n-2}p^2\ln q^{n-2}p^2 = ..., $$ $$ L_2 = \frac{2}{p}(-p\ln p - q\ln q), $$дакле слично очекивању и варијанси L2 = 2L1. Очекивање, варијанса и физичка информација покушаја до другог жељеног исхода су двоструко веће од одговарајућих покушаја до првог жељеног исхода. За разлику од Шенонове, у физичкој Хартлијевој информацији (логаритам свих истих) не рачунају се варијације исхода. Експлицитно ови случајни догађаји се понашају као фермиони, а имплицитно као бозони.
5. Посматраjмо сада и понављање случаjног опита са повољним исходом константне ове вероватноће 0 ≤ p ≤ 1 и неповољним вероватноће q = 1 − p све док се повољан исход по први пун не деси тачно m = 1, 2, 3, ... пута. Са понављањем опита n ∈ ℕ пута и повољним исходом 0 ≤ m ≤ n неповољан исход се десио n - m пута. У истој књизи (Физичка информација, 2019) уз понекад другачије ознаке наводим детаље разматрања и доказе многих ставова од којих овде само помињем неколико.
Низ дужине n са m посебних елемената али са једним посебним на крају низа, могуће је написати на:
$$ \binom{n-1}{m-1} $$начина. Једнако као и исти низ без последњег члана, дужине n - 1 са m - 1 посебних. У сваком таквом дужем има m повољних исхода вероватноће p заједно са n - m неповољних исхода вероватноће q. Он је вероватноће:
$$ P_n(m) = \binom{n-1}{m-1}p^mq^{n-m}, $$а збир свих Pm(m) + Pm+1(m) + Pm+2(m) + ... = 1, па ће ови опити за свако дато m чинити добро дефинисане расподеле вероватноћа. Очекивање су оваквих расподела μm = m/p = mμ1, варијансе су σm² = mq/p² = mσ1², са физичком информацијом:
$$ L_m = -\sum_{k=m}^\infty \binom{k-1}{m-1}q^{k-m}p^m\ln q^{k-m}p^m = ..., $$ $$ L_m = \frac{m}{p}(-p\ln p - q\ln q) = mL_1. $$То је садржај Теореме 2.5.13, горе поменуте књиге (стр. 76), да је физичка информација расподеле „индикатора m пута“ тачно m пута информација „индикатора једном“. При томе, физичка информација у основи је налик Шеноновој, али у Хартлијевим (логаритму броја једнако вероватних) без рачунања поновљених комбинација и које зато третирамо као бозоне.
6. Све ово наводим само као један (ваљда непознат) модел циклуса какав је фотон. На пример, број понављања m као фреквенција, а варијанса па рецимо и информација као замене за енергију. То је и одговор на питање. Уколико би тај модел био „превише“ добар, у односу на оно на шта личи, утолико би он био и „довољно“ добар за физичку стварност. За то ћемо га стављати у тежа искушења, али не овај пут.
Triangular II » eng
Питање: Привукла ме необична анализа индикатора. Јесте ли узимали у обзир и индикаторе променљиве вероватноће?
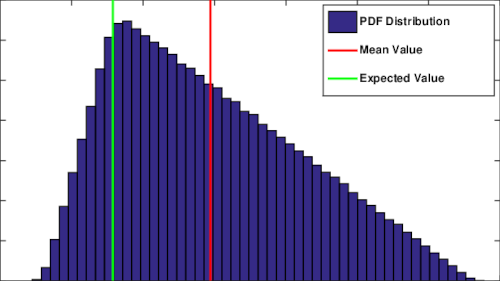
Одговор: Ако желите чути нешто о посебној таквој расподели, као што је трианглуларна, као њихов простији тип, могу је појаснити у истом смислу. На слици лево је једна таква троугаона расподела вероватноћа. Оне линеарно расту од нулте са апсцисом x = a, то све до максималне у x = c, да би даље линеарно падале до нулте у x = b. Приметите да је a < c < b. Плаву површину троугла фарбају ординате ρ(x) густина вероватноћа (енг. Probability Density Function, PDF) које највећу вредност постижу дуж зелене усправне линије, а очекивану дуж црвене.
1. Са висином h = 2/(b - a) датом троуглу припадају темена A(a, 0), B(b, 0) и C(c, 2/(b-a)) када има јединичну површину, а његове горње ивице тиме дефинишу густину расподеле вероватноће ρ(x). Ординате крајњих тачака троугла су густине расподеле вероватноће:
$$ \rho(x) = \begin{cases} \frac{2(x-a)}{(b-a)(c-a)}, & x \in [a, c] \\ \frac{2(b-x)}{(b-a)(b-c)}, & x \in [c, b] \\ 0, & x \notin [a,b] \end{cases} $$Заиста:
$$ \int_0^b \rho(x)\,dx = \int_a^c \frac{2(x-a)}{(b-a)(c-a)}\,dx + \int_c^b\frac{2(b-x)}{(b-a)(b-c)}\,dx = $$ $$ = \frac{2(\frac{x^2}{2}-ax)}{(b-a)(c-a)} \Bigg|_a^c + \frac{2(bx-\frac{x^2}{2})}{(b-a)(b-c)}\Bigg|_c^b $$ $$ = \frac{2[\frac{c^2-a^2}{2}-a(c-a)]}{(b-a)(c-a)} + \frac{2[b(b-c)-\frac{b^2-c^2}{2}]}{(b-a)(b-c)} $$ $$ = \frac{c^2 - a^2 - 2ac + 2a^2}{(b-a)(c-a)} + \frac{2b^2 - 2bc - b^2 + c^2}{(b-a)(b-c)} $$ $$ = \frac{c^2 - 2ac + a^2}{(b-a)(c-a)} + \frac{b^2 - 2bc + c^2}{(b-a)(b-c)} $$ $$ = \frac{(c - a)^2}{(b-a)(c-a)} + \frac{(b-c)^2}{(b-a)(b-c)} $$ $$ = \frac{c-a}{b-a} + \frac{b-c}{b-a}, $$ $$ \int_0^b \rho(x)\,dx = 1. $$Дакле, ординате ивица датог троугла добро дефинишу густину расподеле вероватноће. Овако дефинисане троугаоне расподеле често се означавају са $\mathcal{T}(a,b,c)$.
2. Наћи ћете у књизи Физичка информација (Пример 2.4.8, стр. 58) доказ за математичко очекивање ове расподеле μ = (a + b + c)/3, а за варијансу σ² = (a² + b² + c² - ab - bc - ca)/18. Даље је лако показати да горња зелена линија стоји лево од црвене, c < μ, увек када је лево од средине основице, c < (a + b)/2. Наведена књига (у претходном овом) садржи опис са неким решењима компликација које настају разбијањем континуалне троугаоне расподеле на дискретне.
Укратко, добијемо дискретну троугаону расподелу када делимо основицу b - a на, пожељно је више, n једнаких делова, тако да је сваки део дужине Δx = (b - a)/n. Из пропорције n1 : n = (c - a) : (b - a) следи n1Δx = c - a, или одговарајући број подела n1 од темена A до подножја висине C1 троугла, а затим рачунамо вероватноће p(x) = ρ(x)Δx, односно:
$$ p(x) = \begin{cases} \frac{2(x-a)}{n(c-a)}, & x \in [a, c] \\ \frac{2(b-x)}{n(b-c)}, & x \in [c, b] \\ 0, & x \notin [a,b] \end{cases} $$Потом пређемо на претходни рачун индикатора.
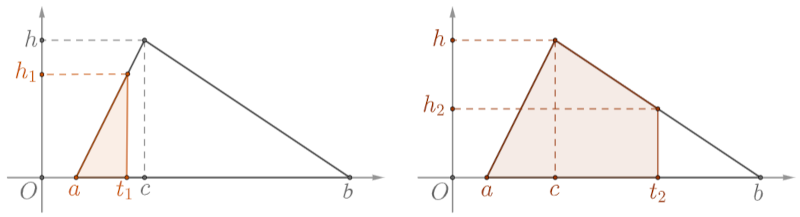
3. Када чекамо жељени догађај овом вероватноћом, онда апсциса говори време, t ∈ [a, b]. Пре тога (t ≤ a) жељеног исхода сигурно нема, док након тог троугла (t ≥ c) жељеног догађаја сигурно има. Шанса да се он деси у време троугла је:
$$ \Pr(x \le t) = P(t) = \int_a^t \rho(x)\,dx = \begin{cases} \frac12(t-a)h_1, & t \le c \\ 1 - \frac12(b-t)h_2, & t \ge c \end{cases} $$ $$ h_1 = \frac{2(t-a)}{(b-a)(c-a)}, \quad h = \frac{2}{b-a}, \quad h_2 = \frac{2(b-t)}{(b-a)(b-c)}. $$Објашњење ових формула је на горњој слици са два троугла. Вероватноћа да ће се жељени догађај десити је P(t) у време a ≤ t ≤ b. Пре тога је нула, а после је један. Када би се дати догађај понављао n = 1, 2, 3, ... пута, истим мереним временом, тада је Pm(t) вероватноћа да ће се жељени догађај за то време десити m = 1, 2, ..., n пута и да се неће десити [1 - P(t)]n-m пута. А то је аналогна формула поменутим дискретним вероватноћама p(x). Оне воде истом, али са много сложенијим објашњењима.
4. Те две вероватноће помножите бројем комбинација $\binom{n-1}{m-1}$ да у низу од n могућих буде тачно m жељених исхода. Последњи члан низа је сигурно жељени и не рачунамо га. Отуда је:
$$ \binom{n-1}{m-1}\,P^m(t)\,Q^{n-m}(t), \quad Q(t) = 1-P(t) $$вероватноћа да ће се у n пута поновљених шанси, у истим условима ове троугаоне расподеле, тачно m пута десити жељени исход. Очигледна је сличност са одговарајућим резултатом претходних индикатора. Отуда и очекивање да се у n ∈ ℕ циклуса фиксних трајања t ∈ [a, b] жељени исход појави тачно m ∈ {1, 2, ..., n] пута износи μm = mμ1 = m/P(t). Варијанса је такође σm² = mσ1² = mQ(t)/P(t), а и физичка информација:
$$ L_m = -\int_0^t\binom{n-1}{m-1}P^m(x)Q^{n-m}(x) \ln P^m(x)Q^{n-m}(x) \, dx = ..., $$ $$ L_m = \frac{m}{P(t)}[-P(t)\ln P(t) - Q(t)\ln Q(t)] = mL_1 $$m пута је већа од информације појаве једног жељеног исхода.
5. Шенонова информација троугаоне расподеле (Физичка информација, Теорема 2.4.15, стр. 63) је:
$$ S_\mathcal{T} = \ln \frac{(b-a)\sqrt{e}}{2}. $$Класична, односно Шенонова, информација мања је од физичке јер:
$$ \binom{n-1}{m-1} \gt 1, $$ $$ \binom{n-1}{m-1}P^m(x)Q^{n-m} \gt P^m(x)Q^{n-m}, $$ $$ [\binom{n-1}{m-1}P^m(x)Q^{n-m}]^{-1} \lt [P^m(x)Q^{n-m}]^{-1}, $$ $$ - \ln \binom{n-1}{m-1}P^m(x)Q^{n-m} \lt -\ln P^m(x)Q^{n-m}. $$Зато што је нумерус логаритма лево већи од десног бива $S_\mathcal{T} \lt L_m$, па за физичку непосредно важи закон одржања информације. Користим ово у разликовању унутрашње од вањске информације (In and Out).
Performances » eng
Питање: Појасните ми мало „унутрашњу“ информацију, ако је то могуће без формула?
Одговор: То што тражите могуће је. Провера формулама учврсти тврђење тако да се оно показује тачним у сваком тачном оквиру, у математици, а тек онда може и интуиција наступати скоро исто безгрешно. Само су теореме тај темељ за неограничене низове дедукција, иначе брзо клизимо ка плићацима, неистинама. Ето зашто нам требају формуле, али када их већ једном имамо, онда је лакше фантазирати.
1. То је уједно и увод у јединственост конкретног (Riesz Lemma) насупрот универзалности апстрактног. Субјекти, живе или мртве природе, свет око себе опажају на јединствене начине; не постоје потпуно једнаке две такве спреге (две информације перцепције), па чак ни код истог субјекта у два различита тренутка. То нам већ говори о нечем „унутар“, што не видимо. Самом виталношћу, која нам је додатак на неживе физичке твари, имамо моћи фантазирања и лагања. Она даје што физичка супстанца невитална не може, а што је уједно и „проклетство“ које нас додатно затрпава својим неистинама. Са виталношћу нам се „унутрашња“ информација и удаљава и приближава. Појаснићу и ово друго.
2. Када статистички анализирамо споразумевање делфина, или црвркут птица (дугим „крааа“ сврака јавља „пријатељ“, док је кратко „кра-кра“ за „опасност“) откривамо више реда него што би то било спонтано. Такође и у бирању хемикалија којима комуницирају мрави, или мириса животиња са њухом. Свици (лат. Lampyridae) су инсекти тврдокрилци названи због светлења током ноћи зарад привлачења партнера или плена, а бирањима сигнала да би били одређенији. Светлост се јавља и својим бојама, али им дубљи смисао даје виталност.
Анализа фреквенције слова смисленог текста даје нижу информацију од бесмисленог. Такав пад открива нам евентуалну комуникацију, пре него што би и знали ко су или о чему би та створења причала. Другим речима, интелигенција нам даје замах, начином потенцијала подигнутог пијука, ради зарањања испод нормалног нивоа неизвесности неживог света. Тај доњи је свет правила, логике и дубљег смисла рецимо, научног поретка или мајсторстава својствених памети. На овај начин ми зарањамо и до „унутрашње“ информације.
3. Природне појаве комуницирају, у физици кажемо интерагују. Сваки од учесника посебно, према својим могућностима и на свој начин, обраћа се околини, представља се и не успева изложити сву своју „суштину“, јер њу заправо и нема на начин како бисмо то уобичајено замишљали, чак нити када се сав преда. Представа вањске информације сваке природне појаве никада није тачна репрезентација њене унутрашњости, иначе нема нити поменуте јединствености (Спрега Информација, стр. 121) или последице, неизбежне различитости конкретних (иста књига, стр. 124).
Отуда сагласности сабирања индикатора (Indicator II, 5) и суперпозиције таласа, такође и неких адитивних природних појава. Са друге стране, ми знамо да таласне дужине испољавају неодређености положаја треперења на њиховом путу, а да са њима расте Сила Неизвесности коју прикривено садрже. Ова неодређеност је унутрашња снага лепршања која се отежано испољава због чега су пулсирања већих таласних дужина већег домета и дуговечнија, околина их мање троши, они околином слабије интерагују, информатички кажемо мање комуницирају.
4. Када двапут бацимо новчић, или бацимо два новчића одједном, увек се зна који је који у смислу да имамо четири независна исхода {ПП, ПГ, ГП, ГГ}, падања „писма“ и „главе“. Понављајући ово са фер новчићима, сваки од ова четири пара груписаће се око четвртине укупних бацања, а биле би то трећине уколико ПГ = ГП. Ово је основна разлика између фермиона, а овде би рекли стварних новчића или евентуало вањских информација, од бозона, унутрашњих информација. Те унутрашње као да се пакују у мање док се претварају да их нема.
Coin flip II » eng
Питање: Објасните ми ово последње, бацање новчића (4), ако је могуће једноставно као и „перформансе“, да бих боље разумео разлику физичке од класичне информације?
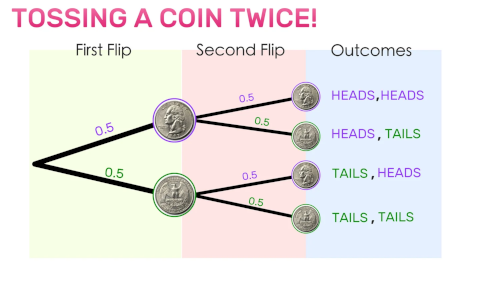
Одговор: Важи. Идемо по реду. Бацамо прво само један новчић, па два, па три, да бисмо видели промене очекивања, варијансе, потом информација Шенона и ове нове, тзв. физичке.
1. Бацамо ли само један новчић (фер) два су једнако вероватна исхода („писмо“ и „глава“). Ако бројимо падање „глава“ онда је x(П) = x0 = 0 и x(Г) = x1 = 1. Те ознаке би требале поједноставити писање. Вероватноће, очекивање и варијанса су:
$$ p_1(0) = \Pr(x_0) = \frac12, \quad p_1(1) = \Pr(x_1) = \frac12 $$ $$ \mu_1 = 0\cdot p_1(0) + 1\cdot p_1(1) = \frac12 $$ $$ \sigma_1^2 = (0 - \mu_1)^2\cdot p_1(0) + (1 - \mu_1)^2\cdot p_1(1) = 0,25 $$Највероватније, математичко очекивање, је μ1 ± σ1, односно 0,5 ± 0,5 а то је од 0 до 1, што и није нека вест. Шенонова информација је:
$$ S_1 = -p_1(0)\ln p_1(0) - p_1(1)\ln p_1(1) = \ln 2 \approx 0,693 $$а толика је и физичка информација овог једног бацања новчића, L1 = S1. Разлика међу те две јавља се приликом бацања два или више новчића.
2. Када бацамо два новчића четири су могућа исхода ПП, ПГ, ГП, ГГ са сваким вероватноће 1/4, али број „глава“ има само три могућности:
0: ПП; 1: ПГ, ГП; 2: ГГ
са вероватноћама, очекивањем и варијансом:
$$ p_2(0) = \frac14, \quad p_2(1) = \frac12, \quad p_2(2) = \frac14 $$ $$ \mu_2 = 0\cdot p_2(0) + 1\cdot p_2(1) + 2\cdot p_2(2) = 1 $$ $$ \sigma_2^2 = (0 - \mu_2)^2\cdot p_2(0) + (1 - \mu_2)^2\cdot p_2(1) + (2 - \mu_2)^2\cdot p_2(2) = \frac12 $$Сада највероватније, математичко очекивање, је μ2 ± σ2, односно 1 ± 0,5 а то је број „глава“ од 0,5 до 1,5 у два покушаја. Шенонова информација је:
$$ S_2 = -\frac14\ln\frac14 - \frac12\ln\frac12 - \frac14\ln\frac14 = \frac32\ln 2 \approx 1,040 $$али је физичка информација бацања два новчића:
$$ L_2 = -\frac14\ln\frac14 - \frac12\ln\frac12 - \frac14\ln\frac14 = 2\ln 2 = 2L_1 \approx 1,386. $$То је тачно двострука информација бацања по једног новчића. Шта се то овде дешава, објашњавао сам претворбом понашања налик фермионима (разликовања новчића) у понашање налик бозонима (неразликовању) и то само код Хартлијеве информације (логаритма броја једнаких исхода) оног дела појаве која постаје унутрашња.
3. Трећи пример, када бацамо три фер новчића и региструјемо колико пута је пала „глава“ поред „писама“, сви могући резултати су:
0: ППП, 1: ППГ, ПГП, ГПП 2: ПГГ, ГПГ, ГГП 3: ГГГ
Када ове збирове, од 0 до 3, распоредимо дуж апсцисе наслућујемо граф троугаоне расподеле. Укупно је осам исхода, па имамо (једине ненулте) вероватноће, затим очекивање и варијансу:
p3(0) = 1/8, p3(1) = 3/8, p3(2) = 3/8, p3(3) = 1/8
$$ \mu_3 = \sum_{k=0}^3 k\cdot p_3(k) = \frac32 $$ $$ \sigma_2^2 = \sum_{k=0}^3 (k-\mu_3)^2\cdot p_3(k) = \frac34 $$Ово математичко очекивање (μ3 = 1,5) каже шта је највероватнији исход у бацању три новчића, да ће пасти једно ипо писмо. Варијанса (очекивање квадратног одступања од очекивања) оваквог опита је σ3² = 0,75 и та нам говори о ширини, распону тих највероватнијих, од μ3 - σ3 до μ3 + σ3, или од 0,63 до 2,37. Информација по Шенону била би:
$$ S_3 = -\sum_{k=0}^3 p_3(k) \ln p_3(k) \approx 1,255 $$док је физичка информација:
$$ L_3 = -\sum_{k=0}^3 p_3(k)\ln\frac18 = 3\ln 2 = 3L_1 \approx 2,079. $$У бацању три новчића, физичка информација једнака је тачно три пута информацији бацања једног новчића. Толико тачно слагање свих ових резултата важан је аргумент у прилог тачности овог дела ове теорије.
4. У свим таквим даљим случајевима, бацања m = 2, 3, 4, ... новчића, биће Шенонова информација мања од физичке (Sm < Lm), а физичка је m пута физичка бацања једног новчића (Lm = mL1). Дао сам њој назив „физичка информација“ јер сасвим опонаша закон одржања (информације) и зато што добро описује неке природне појаве које сам раније чешће помињао.
Овде настављајући ток, приметимо и симулацију начелног минимализма помоћу физичке информације, у смислу да сложене појаве своје вишкове информације прикривају када је се већ не могу отарасити. Друго, тако се засебно чувају вишкови неизвесности, неактивни вањским представама, због чега појава заправо и опстаје у смислу ове теорије где информација чини ткиво простора, времена и материје, а неизвесност је њена суштина.
Binomial II » eng
Питање: Важи ли та ваша прича о „физичкој информацији“ и за бацање нефер новчића много пута?
Одговор: Да, објаснићу, а ви сами одлучите. Прво један кратак увод у биномну расподелу, основну за теорију вероватноће па даље и за статистику. Биномна расподела је тема и теорије информације.
1. Једно бацање новчића решиће дилему код два избора „писмо“ и „глава“. Она је слична бинарним цифрама 0 и 1 који конкуришу за једну исту позицију. Дупла места, две позиције садрже четири (2²) различита бинарна броја: 00, 01, 10, 11. То су децимални бројеви: 0, 1, 2, 3. Три места имају капацитет за осам (2³) различитих бинарних записа: 000, 001, 010, 011, 100, 101, 110, 111. То је осам бројева од нуле до седам закључно. Уопште, ако се на две позиције допишу три позиције добија се пет позиција (2²⋅2³ = 22+3), на неких m ∈ ℕ позиција допише n-m позиција, (0 ≤ m ≤ n ∈ ℕ), добија се n позиција, 2m⋅2n-m = 2m+(n-m) = 2n. Та својеврсна адитивност преноси се на Хартлијеву информацију.
2. Када је појава цифара 0 и 1 на позицијама равноправна, онда је број n позиција Хартлијева информација броја 2n могућих записа. Инверзно је такође тачно. Имамо ли N ∈ ℕ једнако вероватних могућности, биће тада Хартлијева информација једнака логариту базе два тог броја, log2N bit-а (BInary digiT). Тиме је Хартлијева информација „физичка“, за разлику од Шенонове информације.
Иако је N = 1, 2, 3, ... природан број, његов логаритам није, па када имамо позитиван реалан број, r ∈ ℝ+, апроксимирамо, делимо га на приближно једнаке делове и проглашавамо logb r истом Хартлијевом информацијом. Ова је опет адитивна, дакле „физичка“, јер комбиновањем N1 могућности са N2 опција настаје N1⋅N2 опција, a logb(N1⋅N2) = logb(N1) + logb(N2). База логаритма (b > 0) дефинише базу, у физици кажемо димензију, величина информације.
3. Замислимо даље да имамо неку нефер лото машину која вероватноћом p = 0,6 генерише цифру 1 и вероватноћом q = 1 - p = 0,4 цифру 0. Рецимо, ако су у низу од n = 10 извлачења биле m = 3 јединице, онда је у том низу било и n - m = 7 нула. Свака јединица била је вероватноће p = 0,6 и свака нула вероватноће q = 0,4, па је једна таква серија била вероватноће:
pm⋅qn-m = p3⋅q7 = 0,63⋅0,47 ≈ 0,00035
из чега процењујемо да је ово само мали број од много других распореда у истих 10 извлачења. То је само једна могућност од свих комбинација:
$$ \binom{n}{m} = \frac{n\cdot(n-1)\cdots(n-m+1)}{1\cdot 2 \cdots m} = \frac{10\cdot 9\cdot 8}{1\cdot 2\cdot 3} = 120. $$Када их све сабирамо, налазимо:
$$ \sum_{m=0}^n \binom{n}{m}p^mq^{n-m} = (p + q)^n = 1, $$када год је p + q = 1, па имамо добро дефинисану расподелу вероватноћа, бројних независних исхода од којих ће се неки сигурно десити.
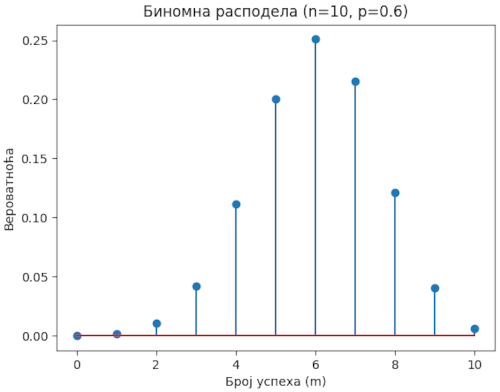
4. На горњој слици десно је биномна расподела:
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import binom

n, p = 10, 0.6
m = np.arange(0, n + 1)
pr = binom.pmf(m, n, p)
print(f"Вероватноћа {m} успеха у {n} покушаја: {pr}")

plt.stem(m, pr)
plt.title(f'Биномна расподела (n={n}, p={p})')
plt.xlabel('Број успеха (m)')
plt.ylabel('Вероватноћа')
plt.show()
То је Питон програм који ће вам поред слике на екрану приказати и следећи текст:
Вероватноћа [ 0  1  2  3  4  5  6  7  8  9 10] успеха
у 10 покушаја: [1.04857600e-04 1.57286400e-03 1.06168320e-02
		4.24673280e-02 1.11476736e-01 2.00658125e-01
		2.50822656e-01 2.14990848e-01 1.20932352e-01
		4.03107840e-02 6.04661760e-03]
где је четврти по реду ових бројева горња вероватноћа и множена својим биномним коефицијентом $\binom{10}{3}\cdot 0,6^3 \cdot 0.4^7 \approx 0,042467$. На слици су свих 11 опција, тачака изнад апсцисе са бројем жељених исхода и ординатама биномним вероватноћама.
5. Одстранимо ли биномни коефицијент $\binom{n}{m}$ и задржимо само производ вероватноћа $p^mq^{n-m}$, просто речено прелазимо са фермиона, тј. Ферми-Диракове статистике:
$$ f_F(\varepsilon) = \frac{1}{e^{(\varepsilon - \mu)/kT} + 1} $$на тзв. бозоне, односно Бозе-Ајнштајнову статистику:
$$ f_B(\varepsilon) = \frac{1}{e^{(\varepsilon - \mu)/kT} - 1} $$где је, у квантној физици, ε енергија стања, μ је хемијски потенцијал, k је Болцманова константа, а T је апсолутна температура. Tе функције f(ε) су средње вредности броја честица енергије ε у датим условима, хемијског окружења и температуре. Мањи називник даје већи број fB исте средине.
За разлику од Бозе-Ајнштајнове статистике, која се примењује на честице целобројног спина (бозоне), Ферми-Диракова статистика, честица полу-целог спина (фермиона), ограничава се на такве које исте не могу бити у истом стању са чиме се смањује њихов број и сужававају њихови избори. Стога бозони имају већи капацитет за информације, са тиме и могућност да апсорбују више неизвесности.
6. Доказ да физичка информација (Ln) биномне расподеле ℬ(n, p) вреди n физичких информација (L1) јединичне биномне расподеле ℬ(1, p) дао сам 2019. у књизи Физичка информација (Теорема 2.3.6, стр. 48). Имате тамо и посебне примере, доказе L2 = 2L1 и L3 = 3L1 за лакше разумевање општег става. Нема потребе да их овде преписујем.
Bounds » eng
Питање: Можете ли ми навести неки конкретан пример о „физичкој информацији“?
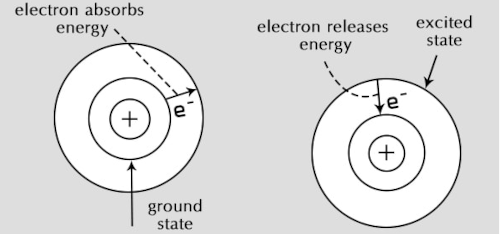
Одговор: Тешко, експерименти и те врсте науке нису мој домен, па могу само фантазирати. Линк на слици лево има једну истражено а ипак инспиративно тумачење о преласцима електрона са више у нижу љуску атома када се фотон емитује и обрнуто, електрон иде са ниже на вишу орбиту када му се та енергија враћа. Покушајте уопште, у променама потенцијала, наћи ту „унутрашњу“ акумулацију. Тачна теорија, ако „физичка информација“ то јесте, уклопиће се у ово или оно, унапред ко зна како. Сетимо се само Дираковог „играња“ (његовим речима) са формулама (Spin III) које су се касније показале практичне.
1. Следи стварност, говори истину, али у неизговореном је твоја највећа снага. Ово је опис карактера (Traits) који дугорочно побеђују, доследно стратегијама I лиге ове теорије, а у којем такође препознајемо концепт „физичке информације“. Лажов је одвратан када се разоткрију његова пропала обећања, јер воња на неуспех, на градитеља кућа од карата, са чиме нас природа кроз еволуцију штити као од мириса трулог, на кугу, заразне болести и уопште пропаст. Поколења тако преносе страхове од неуспеха, одбојност од неуспешних. Међутим, на кратке стазе је лагање привлачно, шаље нам плитке истине које су испод у контрадикцијама и тако згодне за „подвали па бежи“ тактике. Лаж је добра поза за вањски свет и одлика непостојаних појава.
Поред трајања и непротивречности (Packages III), које су теже мерљиве одлике истине, њена одсуства у сложеним појавама могу се препознати помоћу популарности, поменуте особине лажи. Привлачност лажи код бацила види се у заобилажењу имуних система; на пример, бактерије се понекад крију унутар ћелија домаћина како би избегле откривање. Или, упркос недостатку нервног система, многе биљке су веома варљиве. То, попут пчелиње орхидеје која производи мирисе и облике имитирајући женке инсеката, мамећи мужјаке да покушају да се паре са њима, зарад свог опрашивања. Лажи су привлачне и непосредно, што увелико рабе политичари у кампањи или трговци у продаји када варају народ, али и уметници просто да би забављали своју публику.
2. Физика је утегнутија од других наука, егзактнија је и згоднија за пробе нових идеја уколико тражимо њихову велику тачност, па нам се намеће поређење „физичке информације“ са фотоном. Енергија фотона E = hf је пропорционална фреквенцији f = 1/τ, где је τ време једног периода, једне осцилације и то је све, јер h = 6,62607015 × 10⁻³⁴ m2 kg / s је универзална Планкова константа. Фотони су бозони, па нема описаног „претварања“ фермиона у бозоне.
Када фреквенције светлости поредимо са индикаторима и понављањима опита, рецимо варијансом σm² = mq/p² = mσ1² све док се пожељан исход не деси тачно m пута, треба знати да неизвесности нису у енергији самој, већ су паковане у физичком дејству, у производу промене енергије (E) за протекло време (τ). Међутим, то дејство, Планкова константа, не мења се.
На пример, то значи да је бела светлост спој различитих боја које и у тој целини постоје као самосталне светлости, као посебни кванти. Физичка информација целине, Lm = mL1, тада може бити прост збир унутрашњих информација. Примењено на изворе светлости у релативним кретањима ово нам открива занимљиве детаље.
3. У релативном кретању кванти енергије не мењају се ако их израчунамо кроз трансферзални релативистички Доплеров ефекат. Ова упоређивана са повећањем енергије, где је v релативна брзина, а c брзина светлости:
$$ f_T = \frac{f_0}{\sqrt{1 - \frac{v^2}{c^2}}}, \quad E_T = \frac{E_0}{\sqrt{1 - \frac{v^2}{c^2}}}, $$даје непромењену Планкову константу, h = ET/fT = E0/f0. Међутим, има ту једна квака. Време тела у релативном кретању успорено је у односу на сопствено. Сопствене догађаје опажамо пригушене, проређене, са мањом „количином неизвесности“ (информацијом) па као потврду „унутрашње“ акумулације физичке информације. Иначе, ван приче са индикаторима, ово успоравање тумачим као одлазак дела својствених догађаја у псеудо-реалности, у додатне димензије времена. На свој начин, то се уклапа и у „физичку информацију“ па чак и у описано одржање преласком у бозоне.
Наиме, реално је оно што има трајање, има прошлост, а простор је један од магацина сећања стварности. Оно што опажамо у даљинама старо је и у том смислу је простор-време један целовит концепт чију структуру прво чине бозони. Зато је извлачење тих крака система у релативном кретању отежано инерцијом, потом и претварањем њихове потенцијалне енергије у кинетичку.
4. Енергија се троши и за извлачење тела из гравитационог поља и стоји претпоставка да је то сличан механизам инерцијалном кретању. Мислим на обрнут модел (2), који се затим треба проверити теоријом гравитације (општом релативношћу). Дизање тела, удаљавање од центра поља, тражи додатну енергију и такав процес је инверзан повратку вишка (кинетичке) енергије заустављањем тела из претходног инерцијалног кретања. Квант је константне вредности (ако је), па за таква два модела остаје заједничка привлачност споријег тока времена, а то и јесте један детаљ Ајнштајновог тумачења гравитације.
У пакету са горњим (2) и гравитациони потенцијал отежава извлачење те из других димензија времена датог тела. Међутим, оба модела имају исти узрок (начело минимализма) догађаји спонтано теку ка извеснијим. Овде нам остају још два питања, шта са потенцијалом електрона у атому и шта са потенцијалом два електрона који се узајамно одбијају.
Decay » eng
Питање: Силазак електрона на ниже љуске атома и ослобађање фотона подсећа ли вас на распаде честица?
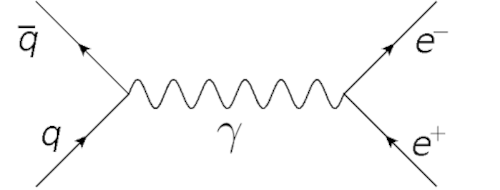
Одговор: Има елемената. Распад и спајање честица путем фотона, као на слици лево са тумачењем, указује на повезаност поменуту у питању. Она је и опомена колико мало познајемо квантну физику. Колико много врата ту још увек чекају да буду отварана.
1. Због закона одржања импулса и енергије, фотон мора да интерагује са јаким електромагнетним пољем да би се могао рапспасти на електрон и позитрон и, при томе, мора имати енергију најмање 1,022 MeV колика је укупно енергија у мировању те две честице у које се распада. Енергији од 1,022 MeV = 1,022 × 106 eV одговара фреквенција f ≈ 2,47 × 10²⁰ Hz, јер је Планкова константа h ≈ 4,1357 × 10⁻¹⁵ eV⋅s и E = hf. Њој одговара таласна дужина λ ≈ 1,21×10⁻¹² m, а она припада гама зракама спектра светлости.
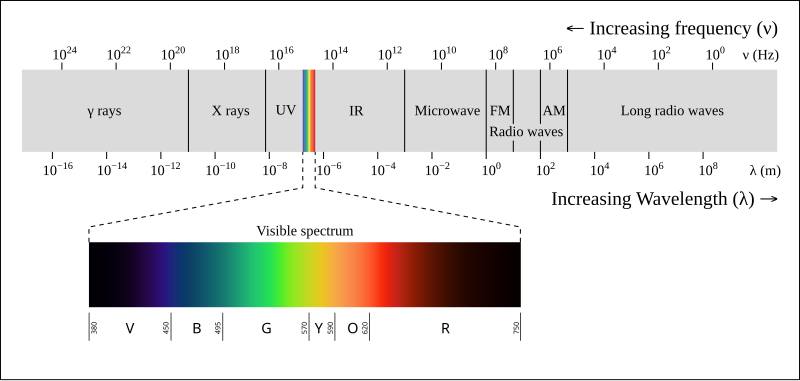
На горњој слици видимо сав светлосни спектар, са гама зракама лево од дела видљиве светлости. Према томе, могуће је, али није лако распадање фотона на електрон и позитрон. Шетање електрона по љускама атома, са преузимањем или отпуштањем одговарајућих фотона, делом подсећа на могућност овог распада.
2. Електрони и позитрони се тиме показују да су грађе фотона. Ово због своје реалности (закона одржања), а онда због паковања информације у кванте одмицање електрона (негативног наелектрисања) од језгра атома (позитивног наелектрисање), указује на исту структуру и наелектрисања самог. Емисијом фотона, корацима са виших на ниже љуске, расклапа се то „недељиво“ наелектрисање електрона око -1,602 × 10-19 C (Coulomb).
Са друге стране, оно указује на сложеност састава информације у фотону и њену разложивост по енергијама и периодама, или по фреквенцијама. Отуда, опет, можемо их упоредити са понављањима опита све до попуне датог броја повољних исхода (Indicator II, 5). Удаљавањем електрона од језгра, супротна наелектрисања се осамостаљују, а то се догађа допунама квантима фотона. Наглашавам квантима, а не енергијом (што је такође тачно), да истакнем информатички карактер процеса. Доследно начелу минимализма, откривамо да електрон спонтано иде доњим орбиталама, јер је тада у мањој неизвесности.
3. Уколико је речено добро, онда смо на трагу објашњавања квантовања светлости у атому за разлику од слободних фотона. Неки начини су већ познати, рецимо методама оператора анихилациjе и креациjе (Квантна Механика, Оператори осциловања, стр. 342), али овде их продубљујемо схватајући да информације колају реалношћу у пакетима, који се налазе и у квантима светлости. Њихови делови могу бити нереалне, али и даље истините апстракције и у изобиљу, чак и стално исте присутне којекуда, за разлику од конкретних појава које су у односу на своје окружење увек различите (Riesz Lemma). Виши ниво пакета таквих су бозони, а даље ту су у стварностима и фермиони.
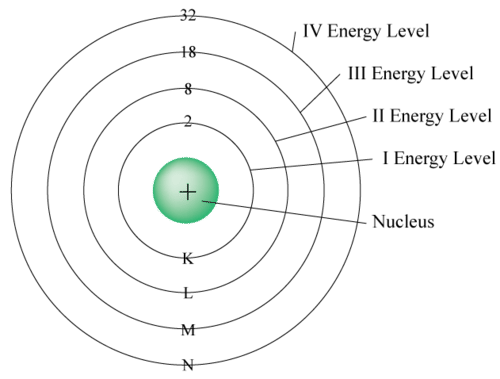
Водећа (хипо)теза такве замисли бива у „поништавању“ супротних наелектрисања приближавањем негативних електрона супротно наелектрисаном језгру атома. На слици десно стоје четири љуске електрона у атому на којима они могу имати енергије тзв. серија: Лиман, Балмер, Пашен, Бракет, па и даље, са до 2, 8, 18, 32, али и даљих електрона. Одмицањем од језгра и енергија електрона расте како расте број кванта, његових пакета информације. Сада кажемо да електрон пружа отпор том увећању због начела минимализма.
4. Максималан број електрона по љускама, од доње (основног стања) па редом даљих n = 1, 2, 3, ..., је 2n². Љуске су подељене на подљуске (s, p, d, f) које садрже орбитале, свака са највеише два електрона. Прва љуска (за n = 1) има једну орбиталу (1s) са два електрона. Друга љуска (n = 2) иде до четири орбитале (2s, 2p) и осам електрона. Тећа љуска (n = 3) има и девет орбитала (3s, 3p, 3d) са 18 електрона. Четврта (n = 4) има 16 орбитала (4s, 4p, 4d, 4f) са до 32 електрона. Електрони у најудаљенијој љусци познати су као валентни електрони и одговорни су за хемијско везивање, док они ближи већ већ имају довољно информација.
Orbitals » eng
Питање: Интеракција фотона са електроном у атому је и интеракција са атомом као целином?
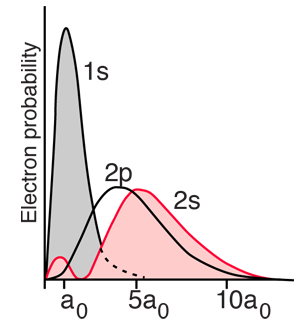
Одговор: Може се и тако рећи, у ширем смислу. Главни квантни број n = 1, 2, 3, ... говори о нивоу енергије електрона (од око 1 eV до 10³ eV):
$$ E_n = -hcR_\infty \frac{Z^2}{n^2}, $$где је h Планкова константа, c је брзина светлости, R∞ Ридбергова константа, Z је атомски број који означава место атома периодног система, или број протона језгра атома. Изведба је Ридбергове:
$$ \frac{1}{\lambda} = R Z^2\left(\frac{1}{n_1^2} - \frac{1}{n_2^2}\right) $$формуле са E = hf = hc/λ и главним квантним бројем n = n1, а n2 → ∞. На пример, енергије везаних стања електрона у атому водоника своде се и на En = E1/n² = -13,6 eV/n². Ове ознаке узете су из Боровог модела. Узајамне интеракције електрона повећавају енергетски ниво, па су тачне формуле много сложеније, али разумемо да су и овакви грубо описани енергетски нивои електрона главни, окосница даље приче о атому. Појаснићу редом.
1. Орбитала је највероватније место електрона из атома. Све већи главни квантни број n = 1, 2, 3, ... значи све већу енергију електрона, удаљавање највероватнијих положаја од језгра, али одређује и облике тих положаја. Други квантни број ℓ ∈ {0, 1, ..., n-1} говори о облику орбитале. Када ℓ = 0 орбитала је облика сфере и има ознаку s. Орбитала код ℓ = 1 ознаке је p а њен облик личи на знак ∞. Када ℓ = 3 ознака орбитале је d и подсећа нас на лептира, а за ℓ = 4 орбитала је ознаке f са још сложенијим облицима.
Ознака s такође значи и подниво (енг. sublevel) орбитале. Обзиром да је увек ℓ ≤ n-1, то подниво првог нивоа (n = 1) може бити само ℓ = 0, а то је s орбитала. Други ниво (n = 2) има орбитале: s за ℓ = 0 и p за ℓ = 1. Потом је трећи ниво (n = 3) орбитала: s за ℓ = 0, затим p за ℓ = 1 и d за ℓ = 2. Четврти ниво (n = 4) има орбитале: s за ℓ = 0, p за ℓ = 1, затим d за ℓ = 2 и f за ℓ = 3. Дакле, први енергетски ниво има само 1s, док други има две орбитале 2s и 2p, трећи је са 3s, 3p и 3d, а четврти 4s, 4p, 4d и 4f. Те ознаке користимо и уз хемијске елементе.
2. Примећујемо како са повећањем енергетског нивоа електрона корак по корак расту облици (могућности) где се електрон може наћи у атому. Ово се још боље види са прирастом магнетног квантног броја mℓ ∈ {-ℓ, ..., ℓ}. То је трећи квантни број и он нам говори о орјентацији. Подниво s због ℓ = 0 има само једну позицију и један магнетни број mℓ = 0. Са ℓ = 1 подниво p има три позиције px, py и pz за орјентације, протезања три магнетна броја mℓ ∈ {-1, 0, 1}, облика знака ∞ дуж три координатне осе.
Подниво d иде уз други квантни број ℓ = 2 и има пет орбитала, са трећим квантним бројем а који су магнетни квантни бројеви mℓ ∈ {-2, -1, 0, 1, 2}. Последњи, четврти квантни број је спин електрона, ms, који може имати само две вредности, тзв. спин-горе и спин-доле. Кажемо за њих и смера су казаљке на сату и обрнуто смера казаљке на сату, или ms ∈ {+1/2, -1/2}. Спин електрона у атому пишемо и стрелицом горе ↑ и доле ↓.
3. Паулијев принцип искључења, предложен 1925. године, каже да било која два електрона (или друга фермиона) у атому или молекули не могу истовремено да заузимају исто квантно стање. Конкретно, атом нема два електрона са истим скупом четири квантна броја n, ℓ, mℓ и ms. По начелу, орбитала може имати до два електрона, тада супротних спинова. Тако се позиције попуњавају, прво истим спином (свеједно којим), а када дође до дуплања додаје се електрон супротног спина.
Тако, адреса 2p5 електрона значи други енергетски ниво n = 2, што значи подниво ℓ = 1 и p орбиталу, са mℓ у три позиције {-1, 0, +1}. Попуњавам их корацима у следећа три реда, идући три са лева у десно истог спина-горе, па још два поново спина-доле:
↑ ↑ ↑ ↑↓ ↑↓ ↑
и тих пет стрелица доњег реда, ознака спина, смисао је горњег индекса 5. То је кратко објашњење, каква ћете опширнија наћи и у књигама хемије.
4. Из особина квантних бројева је видљиво постепено повећавање избора које електрон добија са фотонима. Али, намеће се и утисак да би то могле бити и ослобођене особине целине атома, или можда протона и неутрона из језгра. Решавање Шредингерове једначине (Квантна Механика, 1.4.13 Атом водоника) даје нам те квантне бројеве са мало више објашњења, са јаснијом везом вероватноћа и информације. То посебно због растављања густине вероватноће на факторе у сферним координатама (Orθφ), која су решења те једначине, а која логаритмовањем постају сабирци (логаритам производа је збир логаритама) и Хартлијеве информације. У том смислу, интеракција фотона са електроном у атому јесте и интеракција са атомом као целином.
Random Walk » eng
Питање: Јесте ли се бавили расподелама „случајног хода“ и можете ли ми их објаснити?
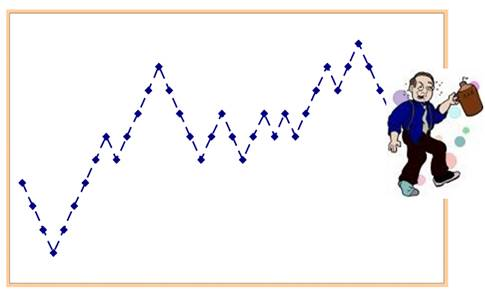
Одговор: Да, бавио сам се неким „слободним ходом тачке“, али то је било и још увек је веома изван познатих истраживања (Физичка информација, стр. 77) и могло би бити и занимљивије од књишких истражених ствари. Надам се.
1. Прост пример случајног хода је по апсциси, x-оси, креће се из O и са константном вероватноћом p ∈ (0, 1) прави се корак десно, или се са вероватноћом q = 1 - p прави корак у лево.
У првом кораку, n = 1, вероватноћа је p да се стигне на место x = 1, а q је вероватноћа да се стигло на место x = -1. У другом кораку, n = 2, из x = 1 се може у x = 2 тада са вероватноћом p² (десно па десно), а враћамо се у x = 0 са вероватноћом pq (десно па лево). У x = 0 се у другом кораку стиже и вероватноћом qp (лево па десно) и збирно је 2pq вероватноћа да другим кораком будемо опет на почетку. Корацима добијамо шему вероватноћа:
... -4 -3 -2 -1 0 +1 +2 +3 +4 ... q p q² 2pg p² q³ 3q²p 3qp² p³
Након n = 1, 2, 3, ... корака тачка која би ишла k = 1, 2, ..., n корака десно, учинила је n-k корака лево. То је Бернулијева расподелa, вероватноће:
$$ P(k,n) = \binom{n}{k}p^kq^{n-k} $$да у n покушаја имамо k померања десно. Након n корака тачка стиже на позицију x = k - (n - k) = 2k - n. Отуда је k = (n + x)/2. Након парног броја n корака биће позиција x паран број, а када је број корака непаран онда је и та апсциса непарна.
2. Математичко очекивање (средња вредност) положаја тачке после n ∈ ℕ случајних корака, од којих су k у десно са вероватноћом p ∈ (0, 1), а зато и n - k у лево са вероватноћом q = 1 - p, износи μn = n(p - q). Доказ тврђења је у књизи Физичка информација (Теорема 2.5.16). У истој књизи следећа теорема утврђује да је варијанса такве расподеле σn² = 4npq.
На пример, када су шансе терурања лево и десно једнаке, p = q = 1/2, тада се случајна тачка очекивано (μn = 0) налази у исходишту са дисперзијом σn = √n. Посматрамо ли удаљености два таква случајна хода, тачака које би кренуле из различитих позиција, то значи да ће се оне пре или касније сретати. Или, популарно кажемо да ће пјанац насумично се гегајући ипак стизати кући. Међутим, ако је кретање у десно вероватније од кретања у лево, p > q, онда ће тачка очекивано одмицати у десно.
3. Математика описује космос са апсурдном тачношћу ... чак и када нема смисла да следимо наше једначине. Нобеловац, физичар Јуџин Вигнер је то назвао „неразумном ефикасношћу математике“. Када би било и једино због тога, треба поменути доследност релација неодређености, Δp⋅Δx ≈ h, брзине померања средње вредности случајног хода, μn = n(p - q), и основе ове теорије да је информација ткиво простора, времена и материје, а да је неизвесност њена суштина, односно да постоје објективне случајности. У том суодносу посебно имамо већу вероватноћу (кретања у десно, p - q > 0) са мањом таласном дужином (λ = h/mv, v ∼ p - q), тј. већу извесност када је таласна дужина мања, или погледајте додатак познатом Комптоновом ефекту у мојој књизи Простор-Време (стр. 34), или не тако давном блогу (Catch a Light).
4. Али, главни део овог „случајног хода“ нису ти детаљи, него Шенонова и физичка информација те расподеле, тим редом:
$$ S(n) = -\sum_{k=0}^n \binom{n}{k}p^kq^{n-k}\log_b \binom{n}{k}p^kq^{n-k}, $$ $$ L(n) = -\sum_{k=0}^n \binom{n}{k}p^kq^{n-k}\log_b p^kq^{n-k}. $$Ово су информације биномне расподеле, од којих за другу важи резултат L(n) = nL(1). Доказ је у књизи Физичка информација, Теорема 2.3.6. То је тада била и још увек је нова врста информације названа „физичка“ због адитивности L(n1 + n2) = L(n1) + L(n2) из које следи закон одржања.
Random Walk II » eng
Питање: Имате ли шта рећи за 2-дим „случајни ход“?
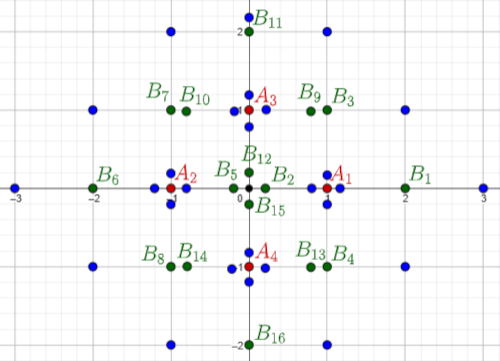
Одговор: Како и у случају 1-дим, слободног корачања по апсциси (x-оси), тако и правоугли 2-дим систем (xy-равнине) разматрамо дискретно. Као случајне потезе, у десно и лево вероватноћа px и qx, а горе и доле вероватноћа py и qy. Ова четири броја су позитивни и збира су један. У 3-дим кретању насумичност би поседовала шест сличних бројева. Уопште, d-дим кретање имало би их 2d. График лево приказује црвене тачке (A1, ..., A4) након једног корака, a зелене (B1, ..., B16) након два корака. Плаве су трокораци. Поредак им је дефинисан у наставку.
Сва стварност какву конкретно опажамо, која физички интерагује, увек је коначне дељивости (Packages), за разлику од њеног „остатка“ (немерљиво већег дела) који садржи и бесконачности. Такве коначности последице су закона одржања и обично их не примећујемо, не морамо када су сагласне са друштвом великих бројева.
1. Видели смо (Random Walk) да је „случајни ход“ по апсици у сваком том n-том кораку у некој Бернулијевој расподели ℬ(n, p). Ово p ∈ (0, 1) и 1 - p су вероватноће корака у десно и у лево:
$$ (p + q)^n = \sum_{k=0}^n \binom{n}{k}p^kq^{n-k}, \quad q = 1 - p. $$Сабирци $P_k = \binom{n}{k}p^kq^{n-k}$ су вероватноће расподеле тог „тетурања“.
Бирајмо за поједине покрете случајне променљиве X1, X2, ..., Xn ∈ {+1, -1}, свака је истог очекивања μ1 = E[X1] = p⋅(+1) + q⋅(-1) = p - q. Отуда се након n корака налази E[∑k μk] = ∑k E[μk] = n(p - q), рецимо је домет n множен брзином појединог корака (p - q). Варијанса једне променљиве је:
σ1² = E[(X1 - E[X1])²] = = p(+1 - (p - q))² + q(-1 - (p - q))² = p(q + q)² + q(-p - p)² = 4pq² + 4qp² = 4pq(p + q), σ1² = 4pq.
Отуда је збир n њих, варијанса 1-дим „случајног хода“:
σn² = E[(X - E[X])²] = nσ1², σn² = 4npq,
а ови резултати, очекивања μn = n(p - q) и варијансе σn² = 4npq, једнаки су онима из претходног одговора, сада изведени на другачији начин.
2. Слично је и са „случајним ходом“ у xy равни, тада је са вероватноћама px, qx, py, qy ∈ (0, 1) кретања десно, лево, горе и доле, px + qx + py + qy = 1. Расподела је налик Бернулијевој:
$$ (p_x + q_x + p_y + q_y)^n = (p_x + q_x + p_y + q_y)\cdots(p_x + q_x + p_y + q_y), $$где вероватноће формирамо тако што из сваке од ових n заграда узмемо по један од четири сабирка који постају множиоци. Вероватноћа низова узастопних и независних догађаја је производ вероватноћа тих догађаја. Попис подсећа на бројање n-цифрених бројева базе четири. На пример, за n = 1, 2, 3, ... имамо 4n позиција, редом:
1 2 3 4;
11 12 13 14, 21 22 23 24, 31 32 33 34, 41 42 43 44;
111 112 113 114, 121 122 123 124, 131 132 133 134, 141 142 143 144, 211 212 213 214, 221 222 223 224, 231 232 233 234, 241 242 243 244, 311 312 313 314, 321 322 323 324, 331 332 333 334, 341 342 343 344, 411 412 413 414, 421 422 423 424, 431 432 433 434, 441 442 443 444;
Пермутације истих бројева сабирају се у једнаке исходе. Тако имамо, 123 132 213 231 312 321, свих шест који из исходишта иду у исту тачку. Према горњем опису то су 2-дим покрети, три корака из O(0, 0), редом:
123: px⋅qx⋅py десно-лево-горе, тачка (0, 1), 132: px⋅py⋅qx десно-горе-лево, тачка (0, 1), ... 321: py⋅qx⋅px горе-лево-десно, тачка (0, 1),
и имамо 3! = 1⋅2⋅3 = 6 одлазака на исто место. Када се понављају само две могућности, на пример, 224 242 422 те све три, $\binom{3}{2}$ = 3!/(1!⋅2!) = 3, воде ка истој тачки (-2, -1) различитим путевима:
224: qx⋅qx⋅qy лево-лево-доле, тачка (-2, -1), 242: qx⋅qy⋅qx лево-доле-лево, тачка (-2, -1), 422: qy⋅qx⋅qx доле-лево-лево, тачка (-2, -1).
Зато сабирака n-тог степена датог збира четири вероватноће има много мање него што би било као горе n-цифрених пописаних бројева базе 4.
3. Дефинишимо вредности појединих корака Xk ∈ {$\pm\vec{e}_x$, $\pm\vec{e}_y$}, k = 1, 2, 3, ..., помоћу јединичних вектора $\vec{e}_x$ и $\vec{e}_y$ коориднатних оса. Као у 1-дим (2), сада у 2-дим случајном кретању налазимо очекивање сваког од корака:
$$ \vec{\mu}_1 = E[X_1] = (+\vec{e}_x)p_x + (-\vec{e}_x)q_x + (+\vec{e}_y)p_y + (-\vec{e}_y)q_y, $$ $$ \vec{\mu}_1 = (p_x - q_x)\vec{e}_x + (p_y - q_y)\vec{e}_y. $$Очекивање V = X1 + X2 + ... + Xn, збира n корака, је:
$$ \vec{\mu}_n = E[V] = E[X_1 + X_2 + ... + X_n] = E[X_1] + E[X_2] + ... + E[X_n], $$ $$ \vec{\mu}_n = n\vec{\mu}_1. $$Подсећам, ове четири вероватноће су ненегативни бројеви збира један, px, qx, py, qy ≥ 0 и px + qx + py + qy = 1, па је брзина „случајног хода“ сада вектор $\vec{v} = (p_x - q_x, p_y - q_y)$, а његов очекивани домет након n корака је вектор $n\vec{v}$.
4. Варијанса случајне вредности Xk ∈ {$\pm\vec{e}_x$, $\pm\vec{e}_y$} сваког појединог корака k = 1, 2, 3, ... је иста:
$$ \sigma_1^2 = E[(X_1 - E[X_1])^2] = $$ $$ = p_x\|\vec{e}_x - \vec{\mu}_1\|^2 + q_x\|-\vec{e}_y - \vec{\mu}_1\|^2 + p_y\|\vec{e}_y - \vec{\mu}_1\|^2 + q_y\|-\vec{e}_y - \vec{\mu}_1\|^2 $$ $$ = p_x[(1-p_x+q_x)^2+(p_y-q_y)^2)] + q_x[(1+p_x-q_x)^2+(p_y-q_y)^2] + $$ $$ + p_y[(p_x-q_x)^2+(1-p_y+q_y)^2] + q_y[(p_x-q_x)^2+(1+p_y-q_y)^2] $$и након уређивања овог израза, лако налазимо:
$$ \sigma_1^2 = 1 - (p_x-q_x)^2 - (p_y-q_y)^2, $$ $$ \sigma_1^2 = 1 - \|\vec{\mu}_1\|^2. $$Варијанса збира n случајних вредности Xk је σn² = nσ1².
5. На пример, када су вероватноће покрета лево и десно једнаке (px = qx) и такође једнаке вероватноће корака горе и доле (py = qy), чак и ако није кретање десно једнако вероватно кретању горе, биће укупно очекивање $\vec{\mu}_n = 0$ са варијансом $\sigma_n^2 = n$. Поново је средње одступање од очекиване вредности $\sigma_n = \sqrt{n}$. Ова очекивања, у 2-дим равни, аналогна су 1-дим оси. Пјанац симетрично тетурајући, пре или касније, вратиће се кући. Аналогно, два која тако тетурају по парку, пре или касније судариће се.
Други пример, када окомитог кретања нема p'y = q'y = 0 и p'x + q'x = 1, па се очекивање 2-дим своди на 1-дим, јер $\vec{\mu}'_n = n(p'_x - q'_x)\vec{e}_x$, и варијанса:
$$ (\sigma'_n)^2 = n[1 - (p'_x - q'_x)^2] = n[(p'_x + q'_x)^2 - (p'_x - q'_x)^2] = 4np'_xq'_x. $$Симетрична су кретања која су једнако вероватна у оба смера сваке од d оса (p1 = q1, ..., pd = qd) и за произвољан број d = 1, 2, 3, ... димензија она сва имају очекивања μn = 0 и варијансе σn² = n, али за d ≥ 3 повратак на почетну позицију неће бити известан.
Random Walk III » eng
Питање: Зашто се „случајне шетње“ губе у 3-дим?
Одговор: Ради се о симетричним насумичним кретањима сваке од правоуглих координата, када сви кораци, ка сваком од смерова оса имају једнаке вероватноће. Тачка у 1-дим систему (дуж x-осе) може ићи лево или десно, има само две могућности свака је вероватноће 1/2. Тачке у 2-дим систему (раван xy) су са по четири могућности и 1/4 вероватноћа. Простор 3-дим има шест смерова (лево и десно, тамо и овамо, горе и доле), сваки вероватноће 1/6. Уопште, у d-простору тачка има 2d смерова сваки 1/2d вероватноће. Са већим d мање су шансе да одлутала тачка нађе пут назад.
1. Објашњења линка на видеу ове слике (горе десно) и слична, за почетне позиције тачке узимају исходиште O система координата. Приметиће да тачка која би се вратила има једнак број потеза у (сваком од) позитивном и негативном смеру, дакле да повратак није могућ у непарно корака, него у 2n неког од n = 1, 2, 3, ..., са исходом вероватноће (1/2d)2n, у простору са d = 1, 2, 3, ... димензија. Вероватноћа да ће се два пута узастопно догодити неки исходи вероватноће p је p², а три пута узастопно је p³ итд. Међутим, треба израчунати на колико начина се може остварити поменути низ 2n корака у повратку до исходишта, сваки вероватноће $(\frac{1}{2d})^{2n}$.
У претходна два одговора о „слободном ходу“ имали смо променљиве за сваки од појединих корака Xk ∈ {+1, -1}, где k = 1, 2, ..., 2n, са очекивањем сваког μ1 = E(X1) = 0 и варијансом σ1² = 1. Збир првих 2n корака је збирна случајна променљива S2n = X1 + ... + X2n са очекивањем:
$$ \mu_{2n} = E[S_{2n}] = E[X_1] + ... + E[X_{2n}] = 2n\mu_1 = 0. $$Варијанса у 2n корака је σ2n² = 2n. Наиме:
$$ \sigma_{2n}^2 = E[S_{2n}^2] = E[(\sum_{k=1}^{2n} X_k)^2], $$ $$ \sigma_{2n}^2 = E[(\sum_{k=1}^{2n} X_k^2] + E[\sum_{i\ne j} X_iX_j], $$ $$ \sigma_{2n}^2 = 2n. $$У првом збиру сваки од квадрата је +1, а у производима десно једнако их има +1 као и -1, и очекивање им је нула. Варијанса је σ2n² = 2n код сваких парних 2n корака, односно стандардна девијација је $\sigma_{2n} = \sqrt{2n}$.
2. У случају кретања само по једној оси, из реченог следи да је верованоћа доласка у полазиште појединог случаја 2n корака P2n ≈ (2n)-1/2. За дужег хода, иначе независних n ∈ ℕ, налазимо да збирна шанса дивергира:
$$ P_2 + P_4 + P_6 + ... = \frac{1}{\sqrt{2}} + \frac{1}{\sqrt{4}} + \frac{1}{\sqrt{6}} + ... \to \infty, $$односно достиже вероватноћу 1 (и премаши је), што значи да је известан повратак тачке у исходиште. Један од начина преласка у 2-дим просторе је да се посматрају независне две окомите осе свака истих вероватноћа, а те случајној тачки дају вероватноће (P2n)² = (2n)-1, сада са збиром:
$$ \sum_{n=1}^\infty \frac{1}{2n} = \frac12 + \frac14 + \frac16 + ... \to \infty, $$који такође дивергира, односно стиже 1 и премашује је, извесност да ће се тачка вратити одакле је кренула. Видимо даље шта ће се догађати када су три осе случајних кретања. Очекивања и варијансе остају исте, али шансе за повратак су мање, (P2n)³ = (2n)-3/2, јер је избора више и то толико да је збир вероватноћа недовољан да гарантује извесност повратка:
$$ \sum_{n=1}^\infty \frac{1}{(2n)^{3/2}} = \frac{1}{2^{3/2}} + \frac{1}{4^{3/2}} + \frac{1}{6^{3/2}} + ... \lt \infty. $$Дата метода је још увек „одокативна“, јер је вероватноћа коју користимо приближна процена, али помаже да разумемо шта се догађа када се број димензија простора слободног хода повећа. Иако је средња вредност свих могућих положаја нула, када тачка крене на свој случајни ход, у простору веће димензије она има све мање шансе да се нађе поново у исходишту. И многе друге тачке за њу су непоновљиве, просто речено, превише их је.
3. Поставимо сада проблем из датог питања мало другачије, прво само са 1-дим случајним корацима дуж апсцисе. Тачка која би се тако враћала ка полазној позицији имала би једнак број корака (рецимо n = 1, 2, 3, ...) и у десно и у лево. Како кад, али био би то увек укупно паран број корака 2n. Сваки такав корак вероватноће је 1/2, па је низ од 2n таквих узастопних вероватноће (1/2)2n и она множена бројем начина да се из низа дужине 2n издвоји n елемената (корака десно, или лево), то је број комбинација, даје вероватноћу таквог једног повратног процеса:
$$ P_{2n}^{(1)} = \left(\frac{1}{2}\right)^{2n}\binom{2n}{n} = \left(\frac{1}{2}\right)^{2n} \frac{(2n)!}{n!n!}. $$Дакле, ово је вероватноћа једног 1-дим случајног хода дужине 2n корака. Подсетимо се да је:
$$ 2^{2n} = (1 + 1)^{2n} = \sum_{k=0}^{2n} \binom{2n}{k} = \sum_{k=0}^{2n} \frac{2n\cdot(2n-1)\cdots(2n-k+1)}{1\cdot 2\cdots k}, $$а ми из целог биномног збира са 2n+1 чланова сада издвајамо само један, средњи и највећи од сабирака. Зато је свака од вероватноћа P2n(1) ∈ (0, 1), али оне не чине расподелу и њихов збир, за све n ∈ ℕ, није један.
На пример, два корака (2n = 2) су: десно-десно, десно-лево, лево-десно и лево-лево. Од те четири равноправне могућности су две које се враћају у полазиште. Такође је $P_2^{(1)} = (2)^{-2}\binom{2}{1} = 0,5$. Од свих 24 = 16 могућности за четири корака, шест је повратних: ддлл, длдл, дллд, лддл, лдлд, ллдд. Такође је $P_4^{(1)} = (2)^{-4}\binom{4}{2} = 0,375$. Затим је:
$$ P_6^{(1)} = 0,3125 \quad P_8^{(1)} \approx 0,2734 \quad P_{10}^{(1)} \approx 0,2461 \ \ldots $$и већ је збир прве три вероватноће, $P_2^{(1)} + P_4^{(1)} + P_6^{(1)} = 1,1875$, довољан за извесност повратка. Збир свих дивергира (Случајни ход 1-дим):
$$ S^{(1)} = \sum_{n=1}^\infty P_{2n}^{(1)} = \sum_{n=1}^\infty \left(\frac12\right)^{2n} \binom{2n}{n} \to \infty, $$што значи да се, слободним ходом по једној оси и бесконачно корачајући, тачка бесконачно много пута враћа у полазиште.
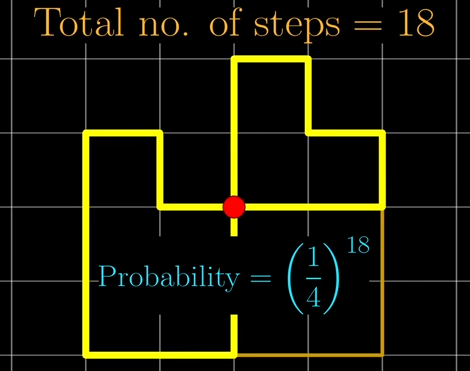
4. Посматрајмо даље проблем тог питања у две димензије. На лево, у 2-дим простору су две повратне путање од 10 и 8 корака, али нека је то једна повратна у 18 корака и вероватноћом 4-10⋅4-8 = 4-18. Иза је питање (видео линка), колико је начина за такав повратак, у 18 случајних корака, а одговор нам даје комбинаторни рачун.
У укупно 2n = 18 корака нека је k корака лево и исто толико десно (овде k = 4), што значи да има n - k корака горе и исто толико доле (овде n - k = 5). Они чине низ елемената (десно и лево, горе и доле) који свега има (2n)! пермутација (овде 18! = 1⋅2⋯18), начина распоређивања. Њих треба смањити k! због понављања покрета у десно и исто толико лево, те (n - k)! понављања горе и толико доле. Вероватноћа једног случајног низа од 2n (овде 18) корака у 2-дим равни множена бројем начина формирања је вероватноћа једног повратног хода од 2n корака:
$$ P_{2n}^{(2)} = \left(\frac14\right)^{2n} \sum_{k=0}^n \frac{(2n)!}{k!k!(n-k)!(n-k)!}. $$На пример, $P_{18}^{(2)} \approx 0,0344$ и за дупло већи број корака $P_{36}^{(2)} \approx 0,0174$, а са троструким $P_{54}^{(2)} \approx 0,0117$. То је споро опадање налик хармонијском реду чији збир такође неограничено расте.
5. Аналогно, у 3-дим простору, вероватноћа збира свих повратних путања дужине 2n корака била би:
$$ P_{2n}^{(3)} = \left(\frac16\right)^{2n} \sum_{j,k=0}^n \frac{(2n)!}{k!k!j!j!(n-k-j)!(n-k-j)!}, $$где је k број корака десно и исто толико лево, j је број корака тамо и исто толико овамо, а преосталих n-k-j је број корака горе и исто толико доле.
Збирoви вероватноћа повратка у 2-дим и 3-дим корацима су:
$$ S^{(2)} = \sum_{n=1}^\infty P_{2n}^{(2)}, \quad S^{(3)} = \sum_{n=1}^\infty P_{2n}^{(3)}. $$Са порастом броја корака, 2n, прва сума довољно нараста у добре шансе за повратке случајне тачке на почетне позиције (Случајни ход 2-дим), за разлику од друге. Умало исто као у претходном примеру (2) и овако бива да враћање у полазни положај код 2-дим случајног кретања постаје скоро извесно, а да код 3-дим то није.
Fictions II » eng
Питање: Како дефиницијом реалности тумачите „случајне шетње“?
Одговор: Реалност је опажљива, трајна и истинита, али постоје и другачије природне појаве, а део њих су фикције којих смо свесни путем виталности. Покушајмо их приметити помоћу тренутка када камен пада у воду гурајући себе у њу из чега настају ти поремећаји по њеној површини, што видимо на слици десно.
1. Низ таквих тренутака обликује нашу стварност. Због јединствености (Спрега Информација, стр. 121) све те стварности бар мало су различите за разне субјекте, па и за „истог“ оне нису исте у различитим тренуцима. Та стална промена је реалност у којој има места за нереалности, међу којима су и фикције, односно оно што ми опажамо јер смо витални. За разлику од мртве физичке природе која има само истину, трајност и мерљивост, ми додатно можемо лагати, умрети и перципирати понешто од физички немерљивог.
Ту је и начело различитости које важи и за 4-дим простор-време. Просто речено, нема статичности нити у стварном моделу простор-времена, бар не на такав начи како је алгебарски, или геометријски, замишљамо када три просторне димензије нижемо у времену по моделу простор-времена. Већ ту је једна интерпретација „реалности“ у тумачењу „случајне шетње“. Наиме, линеарне простори алгебре додајемо повећавајући им димензије при томе не чинећи битне преправке. Међутим, случајни ход по једној и унутар две и три димензије битно је различит. Рецимо, у 3-дим простору је неповратан, док у 2-дим и 1-дим није.
2. Нема статичног 4-дим простор-времена. Недавне нам студије квантне физике сугеришу да се на изузетно малим, микроскопским величинама, време теоријски може кретати у оба смера, напред и назад, отварајући и питање строго једносмерне „стреле времена“. У тим малим размерама, у оквиру ове теорије информације, очекиване су промене и током других димензија времена. Различити субјекти виђају делом исте појаве током различитих процеса у веома малим порцијама, а ми витални уз све то и са даром гледања њих кроз своје фикције видимо и понеке нереалности.
Не прецењујем те налазе „реверзивилног времена“, као што ме се не тичу нити експерименталне потврде моје теорије, него само следим (хипо)тезу да је информација ткање простора, времена и материје, а неизвесност да је њена суштина. Према томе, нити 4-дим простор-време, онакво каквим га данас замишљамо у математици, није довршен опис стварности. Опет, чак и ако су само фикције, неконтрадикторни модели могу бити ваљани.
3. Посматрајмо поново концентричне кружнице око баченог камена, па их замишљајмо као валове на води који се шире, константних таласних дужина λ и све мањих амплитуда a. Нека је σ пречник такве кружнице у датом тренутку, тако да јој је обим 2σ, а површина σ²π/4 и замишљајмо их затим као тачке. У другом координатном систему, оне су тачке x-осе, апсцисе по којој се крећу случајно.
Ако то може тако, онда се положаји „случајне тачке“ гомилају у облике Гаусовог звона:
$$ \phi(x) = \frac{1}{2\pi}\exp(-\frac{x^2}{2}). $$Термин „крива звона“ се обично користи у друштвеним наукама. Она се у теорији вероватоће и статистици назива нормална расподела, а физика је обично назива Гаусововм расподелом, иако се све оне односе на потпуно исту расподелу вероватноћа независних случајних догађаја строгих датих карактеристика, укључујући и чињеницу да је обликована као звоно. Она се, у овом случају, јавља када тачке x-осе посматрамо као површине које покривају концентричне кружнице око камена баченог у воду. Слободан ход таквих „тачака“ као да је неслободан од случајности, рецимо кругова „синхронизовних“ површина са нормалном расподелом, али не и обима.
4. У сличној ситуацији, ширења концентричних лопти у 3-дим простору, поменута област „случајног хода“ је површина лопте. Њена сфера имаће површину S = 4πr² када је њен полупречник r, односно је површине πσ² ако јој је пречник σ. Тада видимо на делу како се „случајне шетње“ губе у 3-дим (Random Walk III). Средња вредност тачака сфере такође је центар лопте, али њена површина одлази и не враћа се.
Упоредо приметимо и демонстрацију адитивности физичке информације случајног хода (Random Walk, 4). У даљим корацима r површина S сфере све је већа док експонент exp(-S) раподеле постаје мањи. Прво се понаша као број корака n, друго је налик физичкој информацији L(n), а треће је попут експонента Хартлијеве информације exp(-L).
Hypergeometric » eng
Питање: Шта рећи о хипергеометријској расподели вероватноћа?
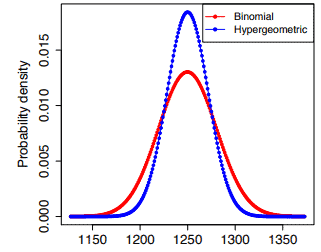
Одговор: Имате о томе детаљно у књизи Математика Лутрије (стр. 93-99), али коју сам писао 2013. године избегавајући да помињем теорију информације. То је мало сложенији облик биномних које сам у истој књизи разматрао тек у наставку (стр. 100-103), просто као мање важне за лото игре.
У биномној расподели се у n ∈ ℕ понављања са враћањем добијају повољни резултати вероватноће p ∈ (0, 1) и, уједно, не добијају са константном вероватноћом q = 1 - p. Иначе, имати r = 1, 2, ..., n повољних исхода од n, могуће је на на:
$$ \binom{n}{r} = \frac{n!}{r!(n-r)!} = \frac{1\cdot 2\cdots (n-r+1)}{1\cdot 2\cdots r} $$начина. Овај број, бином „ен над ер“, пишемо и $C^n_r$, или nCr, а називамо и бројем комбинација. Међутим, у хипергеометријској расподели не враћа се извучени догађај и број почетних опција n на крају се своди на n - r.
1. У најопштијем случају, организатор лото игре n од N на случајан начин извуче n бројева из скупа S = {1, 2, …, N}, а играч на свом уплаћеном низу са M бројева погоди m бројева. Вјероватноћа таквог случајног догађаја је:
$$ \Pr[X = m] = \frac{\binom{M}{m}\binom{N-M}{n-m}}{\binom{N}{n}}, $$где X означава уопште случајне величине дате расподеле, а m је међу тим број пожељних избора. Већ из саме дефиниције ове вероватноће јасно је да је реч о независним могућностима и да је збир свих један. Према томе имамо расподелу вероватноћа.
2. Строжији доказ да је ово заиста расподела је у Математици Лутрије. То је доказ Вандермондовог идентитета:
$$ \sum_{m=0}^n \binom{M}{m}\binom{N-M}{n-m} = \binom{N}{n}, $$из којег непосредно следи да је збир наведених вероватноћа један. Уз то, тамо се налази и доказ да су математичко очекивање и варијанса овакве, хипергеометријске расподеле:
$$ \mu(m) = n\cdot\frac{M}{N}, \quad \sigma^2 = n\cdot\frac{M}{N}\cdot\frac{N-M}{N}\cdot\frac{N-n}{N-1}. $$На пример, Лото Србија (n = 7 од N = 39) користи бубањ са 39 куглица, а за освајање џекпота потребно је погодити 7 бројева.
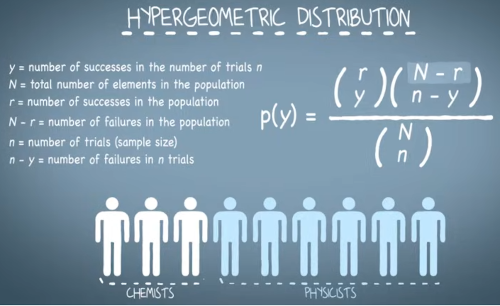
3. Можда је лакши пример слике и линка десно. Бирамо учеснике из групе са три хемичара (M = 3) и шест физичара (N - M = 6), где је број хемичара ознаке r, броја y њихових успешних избора (место m у претходном примеру). Горе у разломку вероватноће је бројник и број начина да се издвоји група од n са y успеха. У бројнику стоји број начина да се узме каквих год ових n из свих N. Када бирамо пет чланова, од којих су два хемичара, то даје N = 9, n = 5, r = 3, y = 2, N - r = 6 и n - y = 3, а отуда вероватноћа:
$$ p(y) = \frac{\binom{r}{y}\binom{N-r}{n-y}}{\binom{N}{n}} = \frac{\binom{3}{2}\binom{6}{3}}{\binom{9}{5}} \approx 0,4762. $$4. Питон програм (Python, 3.11.0) био би:
import math
N, n, r, y = 9, 5, 3, 2
c1 = math.comb(r, y)
c2 = math.comb(N-r, n-y)
c3 = math.comb(N, n)
print(c1*c2/c3)
# Output: 0.47619047619047616
Исти програм ради и са било којим другим бројевима хипергеометријске расподеле вероватноћа.
5. На послетку осврнимо се кратко и на главни део ове приче. За разлику од неадитивне Шенонове информације S(N) = -∑N p(N) ln p(N) хипергео-метријске расподеле, њена физичка информација L(N), шта је год, мора бити таква. Да би она (у мом значењу) била „физичка“ довољно је да буде адитивна:
L(N1 + N2) = L(N1) + L(N2).
Остављам отворено питање да може бити и више таквих поред претходно навођених. То значи, на пример, да би Лото Србије (2) из бубња са N = 39 куглица, уз све остале параметре непромењене, морао бити исте физичке информације као два лото бубња са по N1 = 20 и N2 = 19 куглица, али и са неким другим капацитетима када је N1 + N2 = N.
Fisher » eng
Питање: Како то да остављате отворено питање физичке информације и не наводећи је?
Одговор: Тврђења о функцијама без њиховог тачног одређивања математика познаје као теореме егзистенције. Неконструктивни докази постојања су, рецимо, да функција мора постојати (често коришћењем претпоставке као Аксиома избора), без пружања детаљног алгоритма, формуле или скупа уређених парова који дефинишу функцију конкретно. Једну врсту наводних физичких информација већ сам описивао у књизи Физичка Информација (2.5.1 Индикатори). Тамо је примењена и на биномну расподелу на којој ћу сада демонстрирати још једну такву.
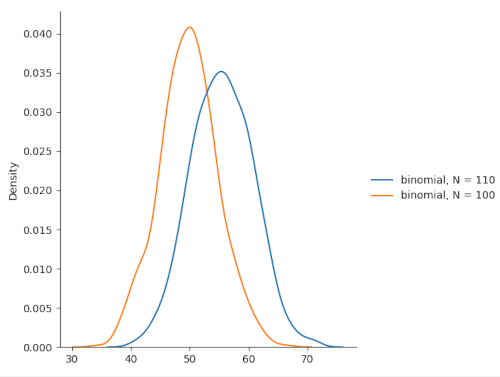
1. На слици лево су две расподеле ℬ1(N1, p1) и ℬ2(N2, p2). Обе су биномне и истих су вероватноћа успешних исхода, p1 = p1 = 1/2, али различитих су укупних понављања опита, виша црвена N1 = 100 и десно померена плава N2 = 110. У оба случаја оне су развоји степена у сабирке (p = q = 0,5):
$$ 1 = (p + q)^N = \sum_{n=0}^N \binom{N}{n}p^nq^{N-n} = \sum_{n=0}^N \binom{N}{n}\left(\frac12\right)^N = $$ $$ = [\binom{N}{0} + \binom{N}{1} + ... + \binom{N}{n} + ... + \binom{N}{N}]\left(\frac12\right)^N $$ $$ = [(1 + 1)^N] \left(\frac12\right)^N = 1. $$Намерно је написано тако да се види да је ова биномна (p = 1/2, q = 1 - p) добро дефинисана расподела вероватноћа $P_n = \binom{N}{n}(1/2)^N$, N = const. А затим, да се види важност биномног коефицијента над (0,5)N = const.
2. У случајевима веома великих бројева поновљених опита (N → ∞) биће бројеви од по неколико промена занемарљиви (ΔN/N → 0) па ћемо онда прећи на диференцијале (ΔN ≈ dN). Покажимо да тада важи:
$$ \frac{d}{dN}\ln\binom{N}{n} = H_N - H_{N-n}, \quad H_m = \sum_{k=1}^m \frac{1}{k}. $$Ови Hm су тзв. хармонијски бројеви. Доказ је једноставан:
$$ \binom{N}{n} = \frac{N(N-1)\cdots(N-n+1)}{n!}, $$ $$ \ln\binom{N}{n} = \ln N + \ln(N-1) + \dots + \ln(N-n+1) - \ln n!, $$ $$ \frac{d}{dN} \ln\binom{N}{n} = \frac{1}{N} + \frac{1}{N-1} + \dots + \frac{1}{N-n+1}, $$а то је тражена једнакост.
3. Примењено на хипергеометријску расподелу, где имамо четири могућа параметра (N, M, n, m) вероватноће:
$$ \Pr[X = m] = \frac{\binom{M}{m}\binom{N-M}{n-m}}{\binom{N}{n}}, $$добијамо различите хармонијске низове. Овде се насумично извлачи n од N могућности. При томе се из скупа са M ≤ N жељених постиже m успеха. Хартлијева информација те вероватноће је њен логаритам, -ln Pr[X = m], а деривација по неком од четири параметра има смисао брзине мењања вероватноће зависно од тог параметра.
4. Попут условне вероватноће Pr(A|B), да се деси случајни догађај A када се дешава B, тј. вероватноћу A под условома дешавања случајног догађаја B, посматрајмо сада уопште промене неке функције f(X; θ) тако што ћемо процењивати утицај параметра θ на променљиве X. Када уместо промена саме функције f посматрамо промене њеног логаритма (ln f), јер те прате једна другу (заједно расту и опадају мада различитим брзинама), можемо посматрати извод ∂θ ln f(X; θ). Када је такав извод позитиван повећањем θ повећава се f, а када је извод негативан повећањем θ смањује се f. Даље налазимо математичко очекивање квадрата таквог извода да би резултат био тзв. Фишерова информација:
$$ F(x,\theta) = E_x\left[\left(\frac{\partial}{\partial \theta}\ln f(x;\theta)\right)^2\right] = E_x\left[\left(\frac{1}{f}\frac{\partial f}{\partial \theta}\right)^2\right]. $$У случају густине вероватноће, очекивање је интеграл, а тај је варијанса:
$$ F(x,\theta) = \int(f'_\theta)^2f\, dx = \sigma_\theta^2[f'_\theta(x,\theta)], $$ $$ F(x,\theta) = -\int\left[\frac{\partial^2}{\partial x^2}\ln f(x,\theta)\right]f(x,\theta)\, dx. $$Према томе, Фишерова информација F(x, θ) је таква да мери флуктуације функције f(x, θ) зависно од параметра θ, уједно је варијанса (по x) извода дате функције по θ. Такође је и негативно очекивање другог извода (узето по параметру θ) логаритма дате функције, а уз то је и очекивање квадрата првог извода.
5. Пример. Проверимо да ли је 1/σ² Фишерова информација нормалне расподеле 𝒩(μ, σ²), односно функције:
$$ \phi(x, \mu) = \frac{1}{\sqrt{2\pi \sigma^2}}e^{-\frac{(x-\mu)^2}{2\sigma^2}}. $$Решење: Хартлијева информација је логаритам вероватноће:
$$ I(x, \mu) = \ln \phi(x, \mu) = -\frac12\ln(2\pi\sigma^2) - \frac{(x-\mu)^2}{2\sigma^2}, $$ $$ \frac{\partial}{\partial \mu}I(x, \mu) = \frac{x-\mu}{\sigma^2} = I'(x,\mu), $$ $$ \frac{\partial}{\partial \mu}I'(x,\mu) = -\frac{1}{\sigma^2} = I''(x,\mu), $$а очекивање ове константе (интеграл нормалне расподеле је један) је Фишерова информација:
$$ F(x,\mu) = -E[I''(x,\mu)] = \frac{1}{\sigma^2}. $$То је требало показати. ∎
6. Пример. Размотримо како се иначе показује да је n/(p - p²) Фишерова информација биномне расподеле ℬ(n, p), или информација вероватноће:
$$ f(n,p,x) = \binom{n}{x}p^x(1-p)^{n-x}. $$Упутство: Овде је p тај параметар, па за вероватноћу расподеле имамо:
$$ \ln f(n,p,x) = \ln\binom{n}{x} + x\ln p + (n-x)\ln(1-p), $$ $$ \frac{\partial}{\partial p} \ln f(n,p,x) = \frac{x}{p} - \frac{n-x}{1-p}, $$ $$ \frac{\partial^2}{\partial p^2} \ln f(n,p,x) = -\frac{x}{p^2} - \frac{n-x}{(1-p)^2}, $$па даље узимамо један опит, n = 1, да нађемо очекивање:
$$ F(1,p,x) = -E\left[-\frac{x}{p^2} - \frac{1-x}{(1-p)^2}\right] = \frac{p}{p^2} + \frac{1-p}{(1-p)^2}, $$ $$ F(1,p,x) = \frac{1}{p(1-p)}. $$Отуда се узима просто F(n, p, x) = n/(p - p²), за n понављања јединичног опита. За строжије објашњење користи се тзв. информант, те припадни тзв. скор статистике. Та, Фишерова информација биномне расподеле, је такође нека физичка информација и приметимо да је другачијег облика од моје, раније поменуте.
Influence II » eng
Питање: Фишерова информација мери узајамни утицај променљивих?
Одговор: Да, може се тако рећи. Фишерова информација:
$$ F(X |\theta) = E_x[(\partial_\theta \ln f(X | \theta))^2] $$или очекивање квадрата промена функције f(X|θ), због мењања X-а (једне или више варијабли), када се мењају параметри θ (један или више њих).
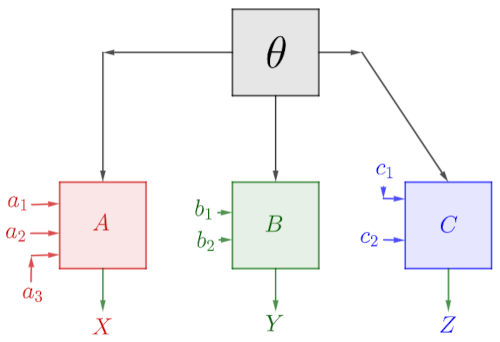
На слици десно је скица утицаја параметра θ, нпр. просечне интелигенције становништва, на економски развој државе A, где су a1 утицаји институција, a2 географије, a3 историје и слично. Затим, на стопу наталитета B, где су b1 обим и старост житеља, b2 приступ образовању и каријерним могућностима женама или слично. Потом C, на смртност од рака и инфаркта, где је c1 нездрава исхрана, c2 загађење ваздуха, и слично. Ове појаве (A, B, C) изразимо величинама X, Y, или Z и тражимо утицај параметра θ на њих. Аналогно, на пример, је деловање виталности на глобалне појаве (Influence). О томе је употреба Фишерове информације.
1. Нормална расподела (звонаста, Гаусова крива) се широко примењује за моделирање природних и друштвених појава где се подаци групишу око централне средње вредности, као што су људска висина, резултати IQ-а и грешке мерења. Она је неопходна за контролу квалитета у производњи и израчунавање ризика осигурања, или одређивање перцентила резултата тестова и анализу научних података.
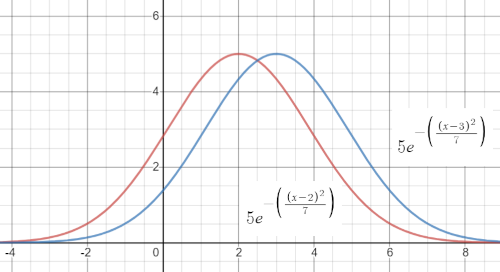
На слици лево су две Гаусове криве нормалне расподеле:
$$ \phi(x; \mu, \sigma) = \frac{1}{\sqrt{2\pi}\sigma}e^{-\frac{(x-\mu)^2}{2\sigma^2}}. $$Лево је црвена очекивања μ1 = 2 и десно је плава са очекивањем μ2 = 3 а обе су варијанси σ² = 3,5. Када је μ параметар Фишерове информације, израчунавамо:
$$ F(x | \mu) = E_x[(\partial_\mu \ln \phi(x;\mu,\sigma))^2] = $$ $$ = E_x\left[\left(-\frac{\partial}{\partial \mu} \frac{(x-\mu)^2}{2\sigma^2}\right)^2\right] = E_x\left[\left(\frac{x-\mu}{\sigma^2}\right)^2\right] $$ $$ = \frac{1}{\sigma^4}\int_{-\infty}^{+\infty} (x-\mu)^2\phi(x;\mu,\sigma)\, dx , $$а овај интеграл је варијанса, тј. σ², па је коначно:
$$ F(x|\mu) = \frac{1}{\sigma^2}. $$Дакле, Фишерова информација опада са квадратом стандардне девијаци-је σ Гаусове криве, тј. са њеном варијансом. Ако је Гаусова крива нижа, са више спљоштеним звоном, онда јој је варијанса већа и размак између две криве на слици изгледао би мањи. Што је више хоризонталан граф, такво померање средње вредности μ било би му мање, смањује му се Фишерова информација и утицај параметра μ на облик графа је мањи.
2. Називаћемо „логаритамским вероватноћама“ (log likelihood) функције ℓx(θ) = ln ℒx(θ), случајне променљиве, а „скор“ функцијама s(θ) = ∂θ ℓx(θ), које су њихови изводи. Највећу вредност логаритамске вероватноће (енг. MLE) добијамо изједначавајући скор са нулом и решавајући по θ, дочим, Фишерова информација је варијанса скор функције. При томе, познато је када извод интеграла бива интеграл извода, ∂θ ∫ fθ(x) dx = ∫ ∂θ fθ(x) dx.
Отуда, за функције густине вероватноће (енг. pdf) имамо:
$$ \int f_\theta(x)\, dx = 1 \quad \to \quad \int\frac{\partial^k}{\partial \theta^k} f_\theta(x)\,dx = 0, $$за узастопне изводе (k = 1, 2, 3, ...), односно $\int f'\,dx = 0$, $\int f''\,dx = 0$, ..., па за ℓ = ln f налазимо изводе и очекивања:
$$ \ell' = \frac{f'}{f}, \quad \ell'' = \frac{f''}{f} - \left(\frac{f'}{f}\right)^2, $$ $$ E[\ell'] = \int \ell' f\, dx = \int \frac{f'}{f}\cdot f\,dx = \int f'\,dx = 0, $$ $$ E[\ell''] = \int f''\,dx - E[\left(\frac{f'}{f}\right)^2] = -E[\left(\frac{f'}{f}\right)^2] = -E[\ell'^2] = -\text{Var}[\ell']. $$Дакле, очекивање другог извода је варијанса скора, односно првог извода функције логаритамске вероватноће, управо што смо имали за Фишерову информацију (Fisher, 4), сада мало другачије. Ово наводим да буде помоћ за евентуална израчунавање приликом примена, у проценама узајамних утицаја променљивих.
3. Закон великих бројева теорије вероватноће каже да се количник датих и свих исхода случајног догађаја групише око вероватноће датог догађаја када се случајни опит понавља. У „информатичком концепту“, стављања времена у приоритет (поновљена вест бајата је), то је деловање прошлих на садашње догађаје и настанак реалности, или пренос информације који говори о њиховом узајамном утицају. Ту смо код Фишерове информације и одговора на постављено питање.
Посматрајмо случајну функцију неког параметра θ дефинисану n-торком (скупова) променљивих X1, X2, ..., Xn, али која је производ појединих:
$$ f_\theta(x_1, x_2, ..., x_n) = \prod_{k=1}^n f_{\theta,k}(x_k), $$ $$ \ell_{n,x}(\theta) = \ln f_\theta(x_1, x_2, ..., x_n) = \sum_{k=1}^n \ln f_{\theta,k}(x_k), $$ $$ \ell'_{n,x}(\theta) = \sum_{k=1}^n \frac{\partial}{\partial \theta} \ln f_{\theta,k}(x_k), \quad \ell''_{n,x}(\theta) = \sum_{k=1}^n \frac{\partial^2}{\partial \theta^2} \ln f_{\theta,k}(x_k). $$Закон великих бројева каже да просек узорка дугим понављањем опита постаје теоријски просек, очекивана вредност. Први извод, та једнакост лево, тако је о средњој вредности. Ето зашто за Фишерову информацију биномне расподеле (Fisher, 6) важи:
F(n, p, x) = nF(1, p, x) = n/(p - p²),
јер и уопште важи F(n|θ) = nF(1|θ). Величина узорка n пута поновљеног постаје n пута поновљен јединични узорак. Ово разумемо статистички.
На пример, од 2022-2023. године, просечан очекивани животни век узет на глобалном нивоу је приближно 72–73 године, али просечан животни век у Србији био је 75-76 година. Средња вредност на широј популацији не мора да се подудара са проценом на мањем узорку, али узимањем све већег и већег узорка долази до све бољег поклапања.
У томе гледајмо ове законитости, рецимо, да ће Фишерова информација нормалне расподеле (1), која у појединачном опиту износи F(x|μ) = 1/σ², понављањем губити утицај дисперзије (као да σ → 0) и расти. Или, када понављајући мерење, у којима настају свакакве грешке мерења, како би узимајући средњу вредност измерених добили тачнији резултат и били боље информисани о стварној величини. Понављам, реч је и о утицају прошлих на садашње.
4. Напослетку је централна гранична теорема (енг. CLT) која каже да се расподела средњих вредности узорка приближава нормалној расподели (крива звона) како величина узорка постаје већа (n ≥ 30), без обзира на основну расподелу популације. Како се величина узорка повећава, тако се средња вредност средњих вредности узорака изједначава са средњом вредношћу популације (μ), док се стандардна девијација (дисперзија σ) смањује. Сви узорци су независни и узимани насумично, па стандардна грешка, дисперзија средње вредности узорка постаје σx̄ = σ/√n. Отуда:
$$ F_n(x|\mu) = nF_1(x|\mu) = \frac{n}{\sigma^2}, $$уопште у Фишеровој информацији много, n пута, понављаној расподели за коју важи централна гранична теорема. Посебно, то је једнакост:
$$ F(n,p,x) = nF(1,p,x) = \frac{n}{p(1-p)} $$у поменутој (3) Фишеровој информацији биномне расподеле. Овај део је прилог претходном одговору (Fisher) на питање „физичке“ информације која није претходно експлицитно наведена.
Accumulation » eng
Питање: Зар није парадоксално да смањујући неизвесност понављањем опита расте “информација“ која је ваљда “количина неизвесности“?
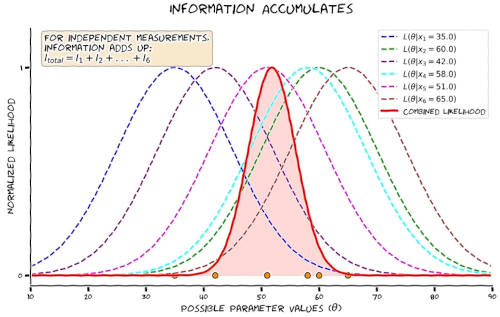
Одговор: Линк слике десно може вам допунити одговор на питање. Реч је о Фишеровој информацији F(X|θ) која представља количину деловања неког параметра θ код променљиве x ∈ X дате функције f(x|θ). Слика више испрекиданих звона густина понављаних опита производи црвену пуну и стрмију линију изнад сјенчене површине звонасте расподеле која долази из централне граничне теореме (CLT). Фишерова информација је просто речено мера тих деловања, акумулација испрекиданих графова на пуни.
1. Знамо да је Шенонова (просечна Хартлијева) информација смисленог текста мања од истог обима насумичног текста (Voltage). То нам открива начин препознавања виталност међу мртвом физичком супстанцом, јер ово је особина уопште смислених деловања. Губитак информације може се постићи из њеног претходног вишка, као што из залета оштар предмет може продрирати дубље, а та моћ долази из вишка количине избора који жива бића имају у односу на нежива. Уосталом способност фантазирања, лагања и непоштења (Honesty) долазе са тим вишком информације коју жива бића имају у односу на неживу физичку супстанцу од које се такође састоје. То видимо у том шиљатом звону горње слике, нагомилан утицај претходних тупљих звона; већи фокус извучен из већих дисперзија.
2. Када постоји, извод функције је нагиб графа, тангенс угла тангенте на граф и апсцисе, у датој тачки. То је скор s(θ) = ∂θ ℓx(θ) случајне функције ℓx(θ) = ln ℒx(θ) која је логаритам функције вероватноће ℒx(θ). Те можемо видети у претходном одговору (Influence II, 2), као и доказ да очекивање скора мора бити нула, E[ℓ'] = 0. Интуитивно, та је тангента хоризонтална (паралелна θ-оси) у средњој вредности, на врху звона, а позитивна графа који расте пре тога и негативна после због графа који опада. Симетрично је позитивно-негативна да би збирно очекивање било нула, из чега следи закључак о усредњавању током понављања опита.
Наиме, појединачне расподеле које би имале спорије успоне графа пред максимумом, имале би тамо мање утицаје параметра и улегнуће крајњег деловања на Фишеровој информацији, а слично и обрнуто. Компензација ових утицаја доводи до симетрије негативних и позитивних нагиба, те до нултог очекивања. Ова „симетрија акумулације“ има још једну причу.
3. Функција је пресликавање једног или више оригинала у највише једну копију. Тако је f1(x) = x² функција која оба броја +3 и -3 копира у број +9, а функција f2(x, y) = log2(xy) пресликава x = 2 и y = 4, или x = 4 и y = 2, па и многе друге парове у исти број 3. Нека је f3(x, y, z) функција чије су три променљиве x(t), y(t) и z(t) на начин функције зависне од праметра t. То значи да је сложени извод ове функције по параметру:
$$ \frac{df_3}{dt} = \frac{df_3}{dx}\frac{dx}{dt} + \frac{df_3}{dy}\frac{dy}{dt} + \frac{df_3}{dz}\frac{dz}{dt} = \vec{f'}\cdot \nabla. $$То је скаларни производ вектора, извода функције и набла оператора:
$$ \vec{f'} = (f'_x, f'_y, f'_z), \quad \nabla = (d_t, d_t, d_t). $$Применом на скор функцију ℓ(t) = ln f(t) и E[ℓ'] = 0 даје да је очекивање логаритамске вероватноће (log-likelihood), па онда и саме вероватноће дате расподеле „површина“ (број променљивих није увек три) на коју би градијент количине деловања параметра (Фишерове информације) био окомит. Скаларни производ је нула само окомитих вектора.
4. Када је функционалан, утицај параметра (θ) на логаритам вероватноће ℓx(θ) = ln ℒx(θ), односно на скор функцију s(θ) = ∂θ ℓx(θ), понаша се попут поља силе. То је у овој теорији информације сасвим прихватљиво, где се информација посматра у пакетима дејства, квантима ΔE⋅Δt = h и уопште неким производима промењене енергије (ΔE) за протекло време (Δt). То узајамно дејство, параметра на функцију вероватноће, рачуна Фишерова информација. Она не изражава информацију у општем смислу (ако би та и постојала), него као узајамни утицај.
Poisson » eng
Питање: Објасните ми Поасонову расподелу?
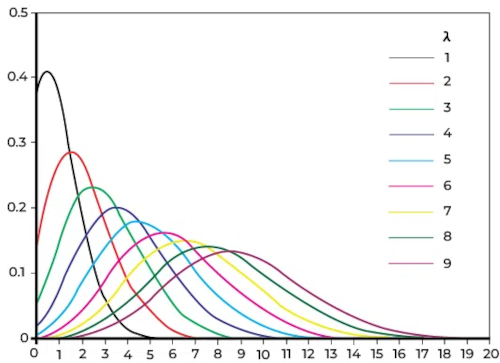
Одговор: У екстремном случаjу, рецимо n > 50 и мало очекивање (µ = np < 10) биномна расподела прелази у Пуасонову, али иначе (µ ≥ 10) у нормалну, тзв. Гаусову (Квантна Механика, стр. 72). Ту је n број опита, са p (реалан број од 0 до 1) вероватноћом жељеног исхода, те q = 1 - p вероватноћом неповољног. Очекивање μ = np и варијанса σ² = npq код биномне изједначуавају се код Пуасонове расподеле, μ = σ² = λ.
На слици лево је граф Пуасонове расподеле:
$$ P(X=k) = \frac{\lambda^ke^{-\lambda}}{k!}, \quad k = 1,2,3,...,n \to \infty, $$редом за све λ = 1, 2, ..., 9. Са порастом очекивања λ = E[P] = np врх графа клизи у десно и смањује се његов максимум, али се површина испод (увек је јединична) до апсцисе шири, јер јој варијанса σ² = λ расте.
1. Потражимо Фишерову информацију F(X|λ) Пуасонове расподеле датог низа опита X = (X1, ..., Xn). Знамо да је F(X|λ) = nF(X1|λ), зато потражимо прво информацију само једног узорка F(X1|λ):
$$ f(x|\lambda) = \frac{\lambda^xe^{-\lambda}}{x!}, $$ $$ \ln f(x|\lambda) = x\ln \lambda - \lambda - \ln x!, $$ $$ \frac{\partial}{\partial \lambda}\ln f(x|\lambda) = \frac{x}{\lambda} - 1, $$ $$ -\frac{\partial^2}{\partial \lambda^2}\ln f(x|\lambda) = \frac{x}{\lambda^2}. $$Отуда Фишерова информација примерка Пуасонове расподеле:
$$ F(X_1|\lambda) = -E_\lambda\left(-\frac{\partial^2}{\partial \lambda^2}\ln f(X_1|\lambda)\right) = E_\lambda\left(\frac{X_1}{\lambda^2}\right) = \frac{\lambda}{\lambda^2}, $$ $$ F(X_1|\lambda) = \frac{1}{\lambda}. $$Дакле, Фишерова информација n-торке Пуасонове расподеле је:
$$ F(X|\lambda) = nF(X_1|\lambda) = \frac{n}{\lambda}. $$То је информација низа опита X = (X1, ..., Xn).
2. Поасонове расподеле се често користе за податке при бројању. То су статистике са бројевима k = 0, 1, 2, 3, ..., попут Ладислауса Борткјевича који је крајем 19. века истраживао случајне смрти пруских војника због удараца коња ногом. Анализирао је 20 година података у 10 армијских корпуса, а што је еквивалентно 200 година посматрања једног корпуса. Открио је да је у просеку 0,61 војника по корпусу сваке године умрло од удараца коња, али већину година ниједан војник није тако умро. С друге стране, једне трагичне године у истом корпусу су четири војника умрла ударом ноге коња. Он (Bortkeiwicz) је био први корисник ове расподеле.
3. На пример, компаније за веб хостинг користе Поасонову дистрибуцију за моделирање броја очекиваних посетилаца по сату које ће веб странице примити. Ако дати веб-сајт има просечно 20 посетилаца на сат, помоћу Калкулатора Поасонове расподеле можемо налазити вероватноће да он има више од одређеног броја посетилаца у датом времену:
- P(X > 25 посетилаца) = 0,11218
- P(X > 30 посетилаца) = 0,01347
- P(X > посетилаца) = 0,00080
Ово даје хостинг компанијама представу о томе колико пропусног опсега треба да обезбеде различитим веб локацијама како би осигурале посебне бројеве посетилаца сваког сата.
4. Поасонов процес испуњава следеће критеријуме:
- Догађаји су независни један од другог. Појава једног догађаја не утиче на вероватноћу да ће се догодити други догађај.
- Просечна стопа (догађаји по временском периоду) је константна.
- Два догађаја се не могу десити истовремено.
Ево неколико примера са вежби студената FIU.
4а. Пример. Просечног радног дана, конобарица не добија бакшиш од 5 муштерија. Израчунати вероватноћу да данас неће добити бакшиш од 7 муштерија.
Решење: Конобарица у просеку дневно има 5 муштерија које не остављају бакшиш: λ = 5. Случајна променљива X = 7 је број муштерија које би биле данас без остављања бакшиша, а нас интересује:
$$ P(X = 7) = \frac{e^{-\lambda}\lambda^k}{k!} = \frac{e^{-5}\cdot5^7}{7!} \approx 0,10444. $$Са том вероватноћом нема тачно 7 бакшиша у једном од десет дана. ∎
4б. Пример. Током типичне фудбалске утакмице, тренер очекује око 3,2 повреде. Израчунајмо вероватноћу да ће тим имати највише 1 повреду у овој утакмици.
Решење: Сада је λ = 3,2. Нас интересује вероватноћа:
$$ P(X \le 1) = \sum_{k=0}^1\frac{e^{-\lambda}\lambda^k}{k!} = \frac{e^{-3,2}\cdot 3,2^0}{0!} + \frac{e^{-3,2}\cdot 3,2^1}{1!} \approx 0,17120. $$Са том вероватноћом у једној од око 5,8 утакмица дешава се највише једна повреда играча. ∎
4ц. Пример. Мала компанија за животно осигурање у просеку има шест захтева за смрт дневно. Нађимо вероватноћу да ће она добити бар седам смртних случајева на случајно одабрани дан.
Решење: То је вероватноћа да их неће бити шест или мање:
$$ P(X ≥ 7) = 1 - P(x ≤ 6) \approx 0,39370, $$што се догађа једном у просечно 2,54 дана. ∎
|
|
|